2026年9月28日,AMD宣布以约82亿美元全股票收购李飞飞创办的World Labs,李飞飞将出任AMD执行副总裁兼首席科学家。这是AMD历史上规模第二大的收购案。一家成立仅两年的公司获得芯片巨头如此定价,意味着AI的竞争重心,正从数字世界转向物理世界。
视线转回国内。影身智能早已在同一条路上跑出完整答卷:以原生4D世界模型为核心引擎,打通从数据采集、模型训练到场景落地的全链条,并已经把这台“引擎”装进了真实产线。
影身智能创始人、CEO闵伟有一个直截了当的判断:“数据从来不是多少的问题,而是维度问题。”这与李飞飞从ImageNet到World Labs一以贯之的“数据焦虑”,形成隔空呼应。
一个在硅谷为空间智能定价,一个在中国车间为物理智能验证。看懂这两件事,就看懂了世界模型赛道的上半场:方向已无悬念,真正的分野才刚刚开始。
一、AI走向物理世界的“必答题”
世界模型要“预测下一个物理状态”。业界普遍认为,这是AI从数字智能迈向通用物理智能的关键路径。
但共识之下藏着硬瓶颈:世界模型需要同时具备三维空间信息与时间维度的4D数据,这类数据获取成本极高、供给极度稀缺。物理世界的信息是物体、接触、力、形变及其在时间上的演化——用二维视频或静态3D数据训练世界模型,信息在源头就被降维了。这解释了行业的集体困惑:训练数据从十万小时堆到千万小时,泛化能力却没有本质突破。
影身智能把这个困局称为“维度鸿沟”:机器人训练用一维语言加二维视频,处理却要在四维物理世界中交互,这是机器人能力没有突破性进展的底层原因。
要走4D世界模型这条路,对团队有两个硬要求:一是三维视觉和动态重建的学术积累,二是机器人进入真实产线的工程落地能力。同时具备这两项能力的团队,在国内屈指可数。
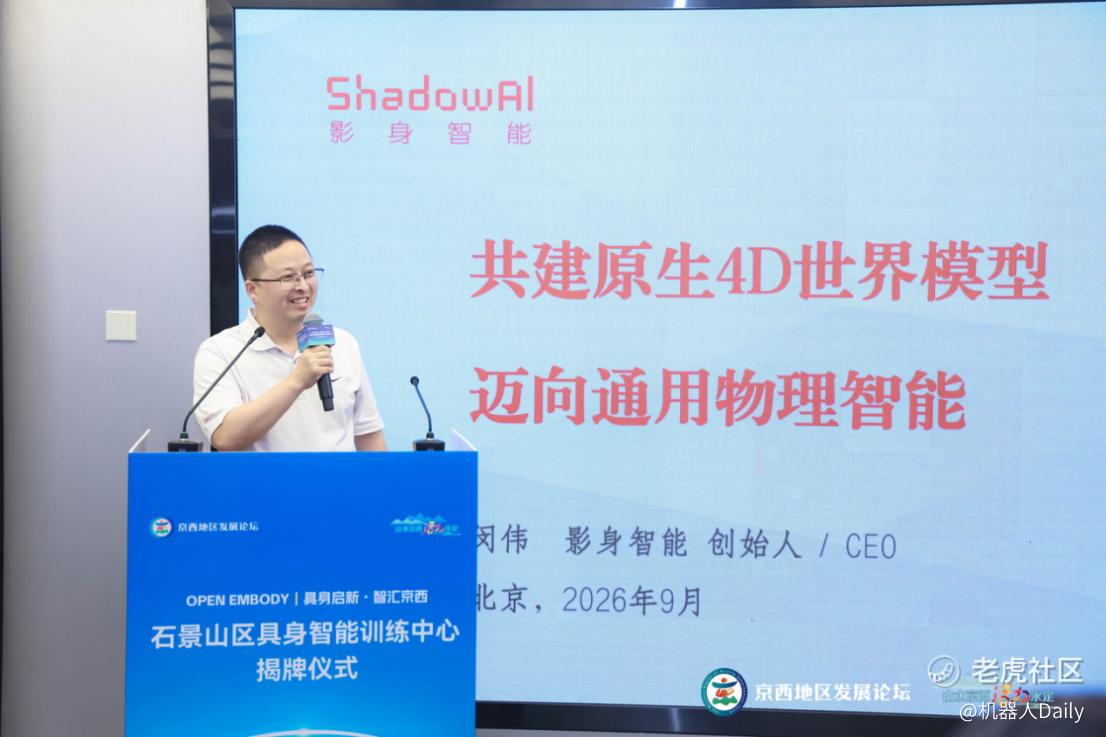
自成立起就押注原生4D世界模型的影身智能,是少数同时满足这两个条件的团队:创始人闵伟是清华博士、原阿里机器人业务负责人,有20余年AI与机器人领域经验;首席科学家刘烨斌教授是清华自动化系长聘教授、国家杰青,深耕三维视觉、3D与4D内容生成,数字人;特别科技顾问朱煜教授为清华机械工程系长聘教授;目前影身智能研发人员占比超90%,形成“80后产业落地骨干+90后至00后硕博4D世界模型研发团队”的人才结构。
2024年,李飞飞创立World Labs,影身智能同年成立。两条路线底层逻辑相同:AI要理解物理世界,数据维度必须升维。区别在于切入方式:World Labs先建立通用模型能力,再向应用场景延伸;影身智能从数据源头切入,先用4D数据把模型“喂”起来,再把它送进产线。技术同源,路径有别。
二、一次从数据源头开始的“全链条重造”
世界模型已成具身智能行业的战略制高点,但“何为合格的世界模型”,业界至今没有统一标准,路线明显分化:有的基于视频数据走生成式路线,强调视觉真实感;有的从三维重建入手,追求几何结构的精确;有的叠加物理引擎,增强动态模拟能力,各执一端。
这些分化背后,是两个绕不开的共同短板。一是数据维度上的降维损失:主流路线依赖低维数据,信息逐层损耗;二是功能维度上的割裂分立:渲染解决“看得见”,仿真解决“算得准”,规划解决“动起来”,三者各成一套,尚未形成完整的物理智能闭环。行业竞争的表层是“谁的演示更惊艳”,里层则是这两个短板谁先补上。
影身智能的选择,是把整条链路重造一遍。2024年成立时,正值大语言模型最热、行业最迷信数据规模的时刻,影身智能就从数据源头开始,把“数据—模型—应用”三个环节按同一个4D标准重构。
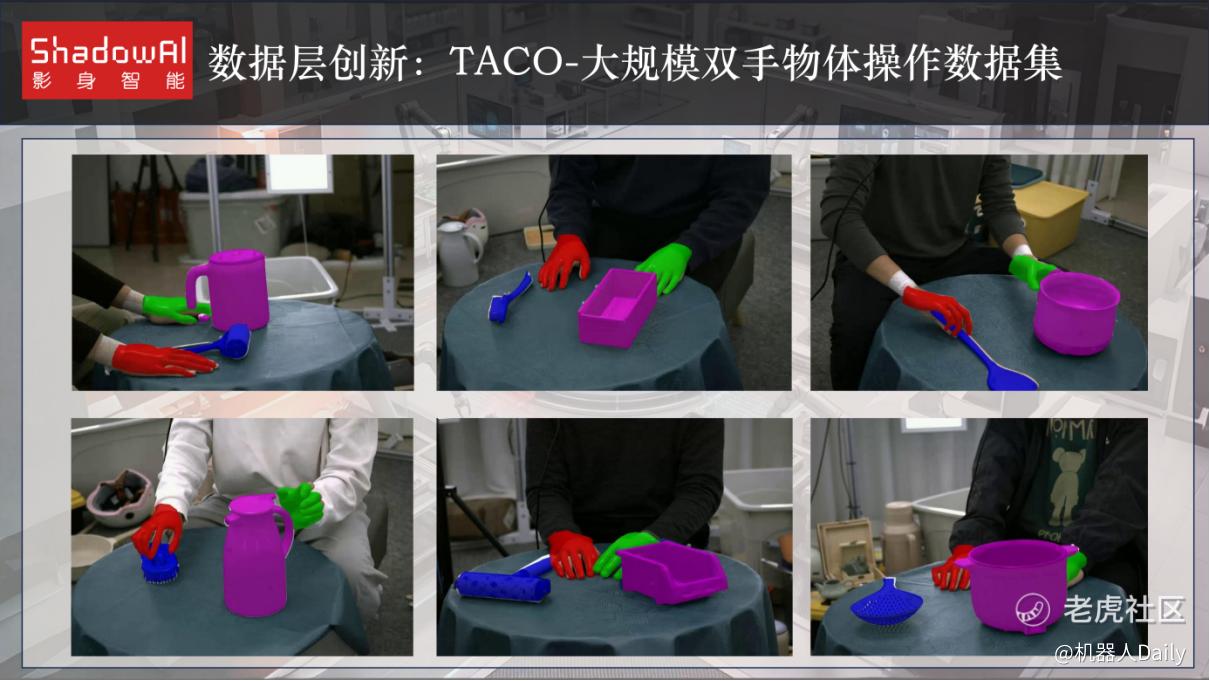
数据层是自研的“影身360”采集系统:4到6个家用级RGB摄像头加消费级GPU,即可实现毫米级精度、每秒25帧的实时4D数据生成,过去高质量4D采集设备单套要数百万元、租一天上万元,影身智能把摄像头从80个降到4到6个,硬件综合成本降低超90%,出数据时间从几小时压到实时。
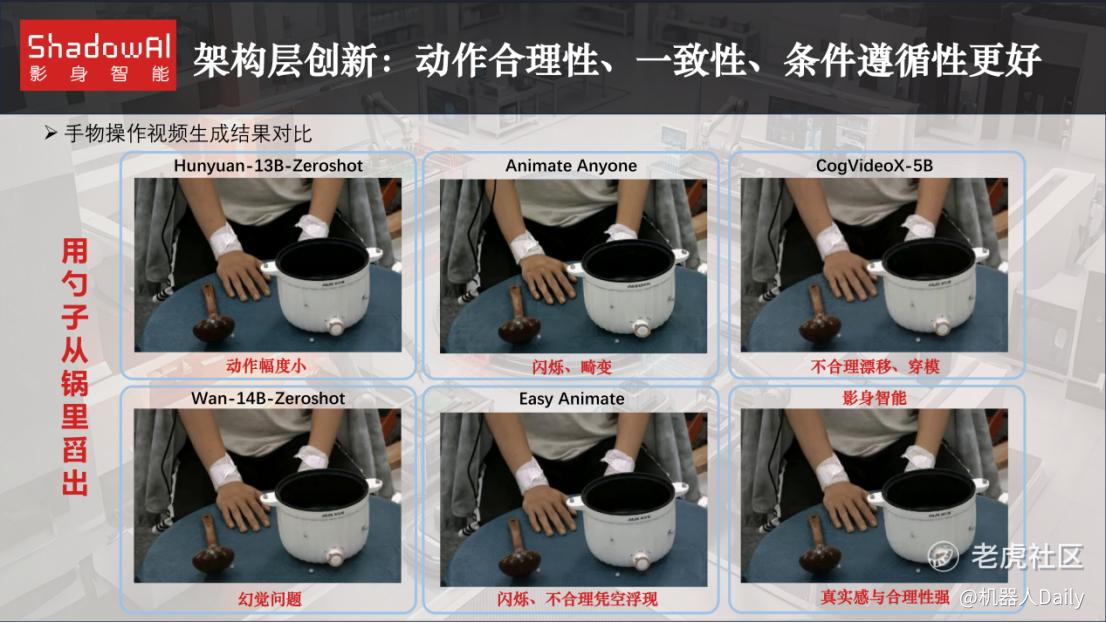
模型层是自研的4D基座世界模型“破界S1”,以统一时空表征把重建、理解、生成放进同一套体系,正面回应“功能割裂”的行业短板:SharpTimeGS在统一框架下同时解决静态漂移与动态模糊两大难题;GAF高斯动作场一次前向传播同时完成重建、预测、决策,动态操作任务平均成功率比此前最优方法高出10个百分点以上。
进化层是“real-to-real”路线:数据直接从真实作业场景获取并迭代,训练与实战同域,落地更可靠;真实场景沉淀的成功与失败案例持续反哺模型,模型变强后再落地更多场景。
三层叠加,影身智能真正完成的是让“感知物理世界—理解物理规律—驱动物理动作”在同一套4D体系里闭环运转。数据是它的燃料,但4D世界模型,才是这台引擎本身。
这条路线的价值,还在从企业闭环外溢为行业基础设施。今年9月,石景山具身智能训练中心在首钢园揭牌,影身智能以核心共建方、一期4D基座世界模型主建方身份深度参与。一期2.0正式升级为“4D世界模型驱动的具身智能多模态数据飞轮”:以4D世界模型为统一底座,构建“采集—建模—训练—验证—回流”闭环,融合数据生成、多模态融合、VLA、ICL训练能力,这是国内首个由4D世界模型驱动的具身智能数据与训练基础设施。这一事件的含义在于:原生4D路线不再只是一家公司的技术选择,而开始成为可公共复用的产业底座。世界模型的竞争,表层是模型效果之争,深层是“谁能把真实物理世界持续、低成本地转化为模型能力”的全链条效率之争,当这样的基础设施出现时,赛道的竞争规则就变了。
三、世界模型的成色,要在产线上检验
检验一个世界模型成色最好的方式,不是演示视频,而是把它放进行业公认最难的场景。据闵伟在晋江调研时的说法,服装鞋帽行业从业人员约四千万、用工缺口巨大,而制鞋等行业自动化渗透率不足5%。最关键的卡点是“双柔性”:材料柔性,鞋面布料受力即形变,机械臂抓不住;任务柔性,鞋款按月迭代、小单快反,传统自动化换款就要花一两天重新编程调试。
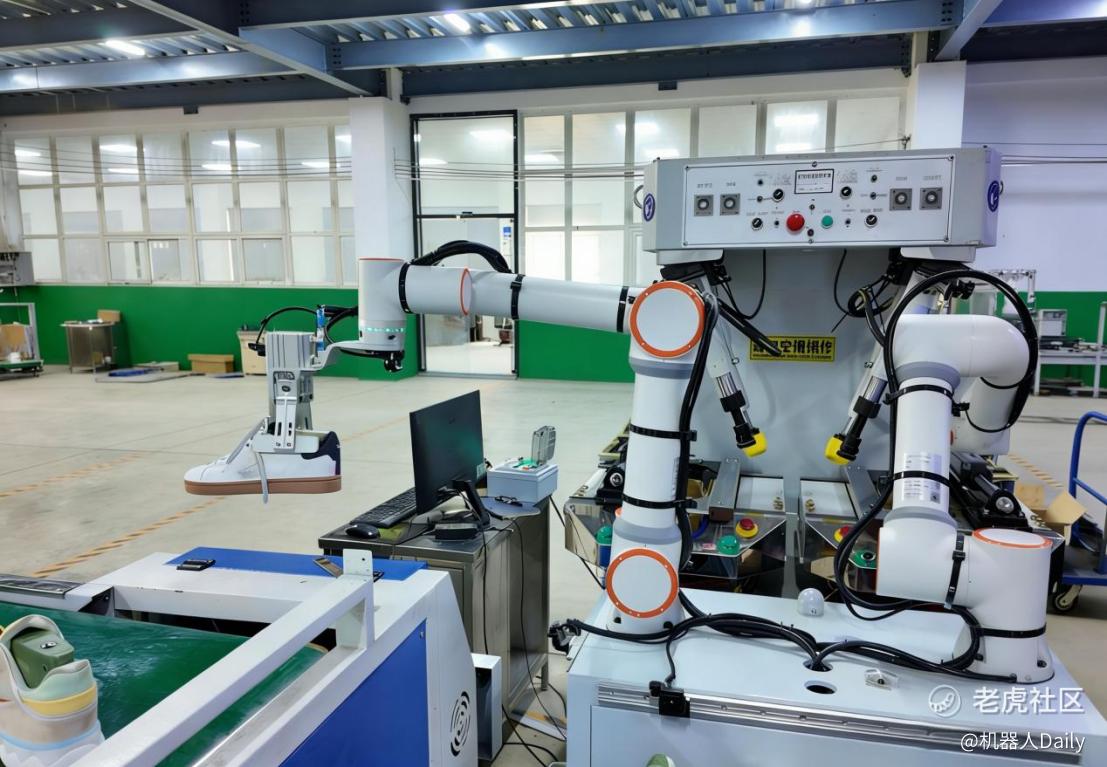
影身智能的三款机器人由此入场:ShadowGlue涂胶机器人通过观看工人操作视频即可自主学习工艺逻辑,实时感知胶水粘稠度变化,0.1秒内完成动态补偿,物料浪费率小于1%;ShadowPress压底机器人实现亚毫米级精准对位,良品率99.9%以上,支持7×24小时无人化作业;ShadowBox打包机器人在东博会现场完成连续折纸盒演示。落地标准是“三个零”:零产线改造、零停工、零驻场。影身智能真正验证的是模型面对一双从未见过的鞋时,是现场推理它的状态,还是只会回放一条写死的轨迹。
但具身智能的商业化从来不看发布会,只看工厂的三笔账:接不接得进产线、干活稳不稳、多久回本。晋江制鞋企业华增鞋业的公开评价是一次实考:“影身智能的系统今年3月进入压底、涂胶工序,承担实际大货订单生产,效率、稳定性都很出色;机器人可直接嵌入原有流水线,不需要做大的产线改造。”按该厂测算,投资回收周期约一至两年。
商业脉络也在延展。2026年,影身智能在手柔性智造订单达到数亿元级别,排产规模千台级;今年上半年,与越南多家服装企业达成战略合作,首批合同涉及数百台设备,金额数千万元。
从路径价值看,如果4D世界模型能在制鞋这种最难的“双柔性”场景中跑通,那它就具备了向箱包、家居、服装等同类柔性制造场景复制的能力。制鞋不是终点,是验证载体。
同一套底层能力还在向外溢。影身智能已将4D采集重建能力延伸至数字文娱,围绕高保真数字人、音视频同步对话、实时多模态交互等方面完成核心技术积累;4D直播系统让观众从“单向观看”走向“置身场内”,公司目前正在与知名导演合作制作4D短片,验证4D内容从采集到成片的完整生产流程;居家生活方向处于技术预研与场景验证阶段。底层能力跨工业与内容复用,既提高技术利用率,也增加真实数据入口——4D世界模型正在从“单点工具”长成“产业底座”。
结语
82亿美元是一笔收购的价格,也是一个问题的价格:AI如何理解物理世界。李飞飞和AMD用资本给出了他们的回答方式;影身智能用两年时间给出了另一种:把模型埋进产线,让真实世界自己来教。
这两种回答并不矛盾,反而互为印证。方向被反复确认之后,竞争的焦点正在收窄为一件事:谁的模型不只是在演示里聪明,而是能在真实的物理世界里,日复一日地把活干对。
世界模型的故事,第一章写在实验室和发布会里,第二章写在真实场景的作业数据里。现在,第二章才刚刚翻开。
精彩评论