9月以来,AI半导体的基本面出现了一个明显变化:增长不再集中在GPU一个环节。英伟达的数据中心收入仍在高速增长,Broadcom的定制AI芯片收入开始进入百亿美元级,HBM紧缺继续向高容量服务器内存与企业级固态硬盘传导,先进制程、存储扩产和先进封装则开始反映在设备商的收入与指引里。
一、万亿美元资本开支,仍是这轮半导体景气的底盘
所有半导体链条最终都要回到一个问题:云厂商还有没有能力继续投入。
从公开财务数据看,答案暂时没有变化。NVIDIA FY27Q2实现营收 962亿美元,同比增长 106%;其中数据中心收入 890亿美元,同比增长 117%,环比仍增长18%。公司给出的FY27Q3收入指引进一步升至1080亿美元。
云侧同样保持扩张。Microsoft FY26Q4实现收入900亿美元,同比增长18%;Microsoft Cloud收入593亿美元,同比增长27%,Azure全年收入首次突破1000亿美元。
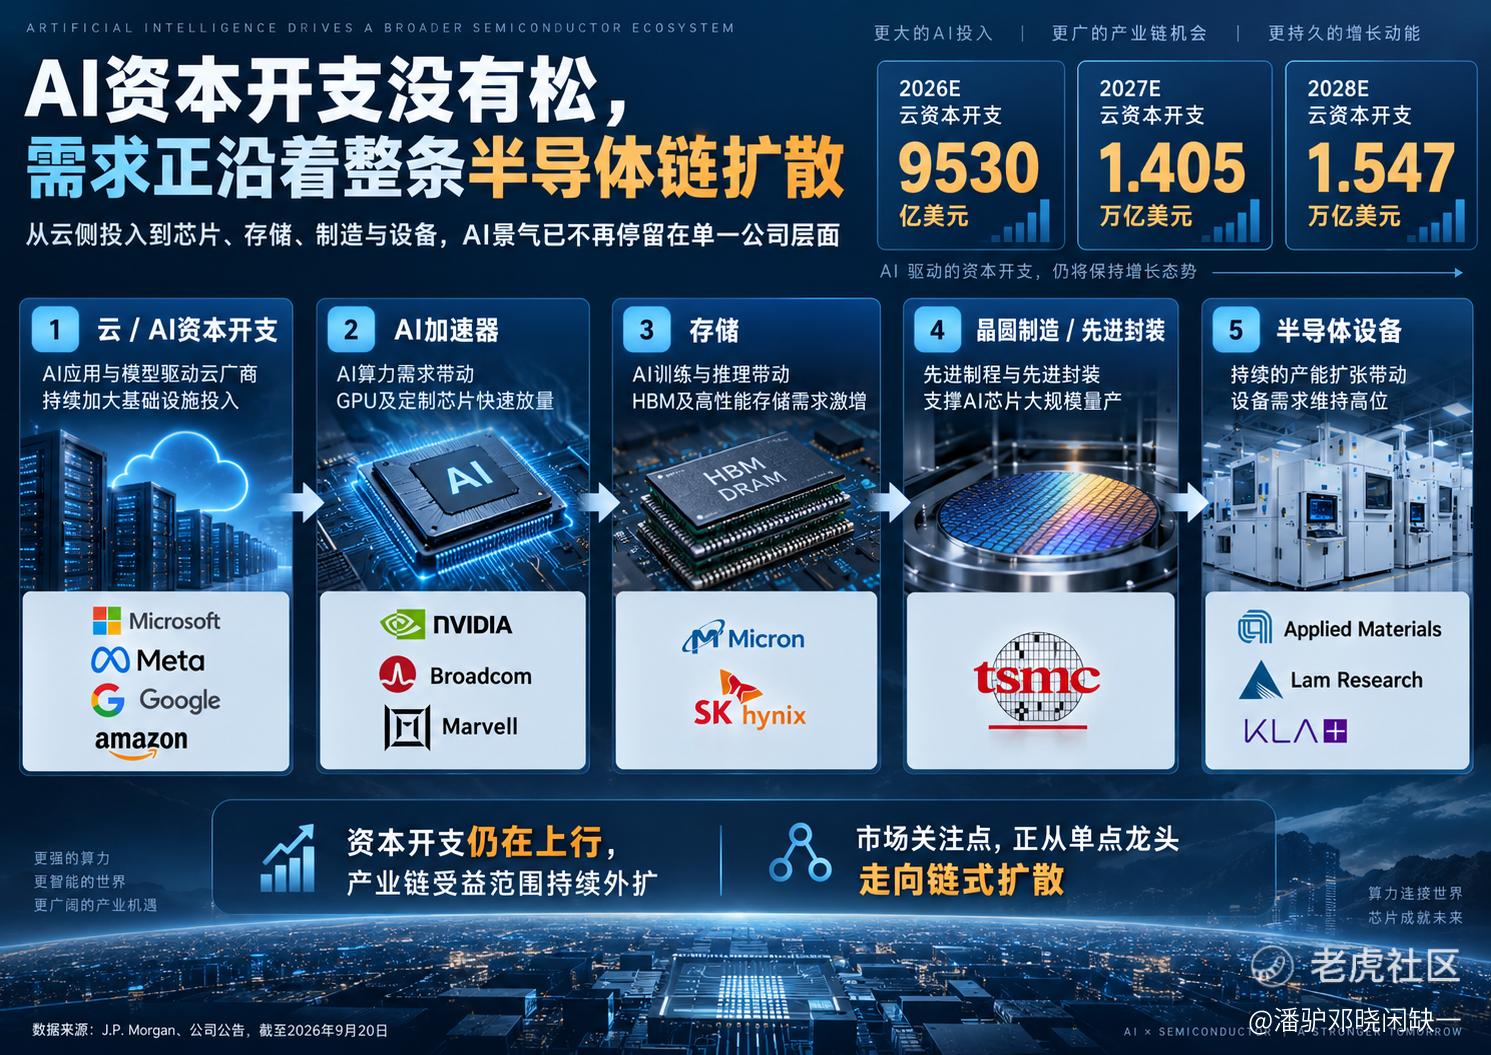
摩根大通汇总Amazon、Google、Microsoft、Meta、Oracle及部分新型云服务商后,预计Cloud Capex在2026年约为 9530亿美元,2027年升至约 1.405万亿美元,2028年进一步达到约 1.548万亿美元。
这个规模的资本开支不可能只停留在GPU采购。服务器数量上升之后,交换芯片、光互连、HBM、DDR5、企业级SSD、先进封装和晶圆制造设备都会同步增加。半导体景气向外扩散,本质上是同一笔AI基础设施投资在产业链不同环节陆续确认收入。
二、GPU继续高增,ASIC开始进入财务报表
GPU没有降速,但定制AI芯片已经从设计项目变成收入。
Broadcom FY26Q3收入295.9亿美元,同比增长86%;其中AI半导体收入达到 167亿美元,同比增长 221%、环比增长54%。公司预计FY26Q4 AI半导体收入继续升至 217亿美元,同比增长236%。
这组数字意味着,ASIC已经脱离过去“项目很多、收入很远”的阶段。OpenAI与Broadcom今年6月公开Jalapeño,首代芯片从设计推进至生产只用了9个月,计划从2026年底开始部署,后续是多代、吉瓦级的平台路线。
Marvell的方向类似。FY27Q2公司收入27.39亿美元,同比增长37%;数据中心收入增速进一步加快至46%。公司给出的下一季度收入指引约31.5亿美元。
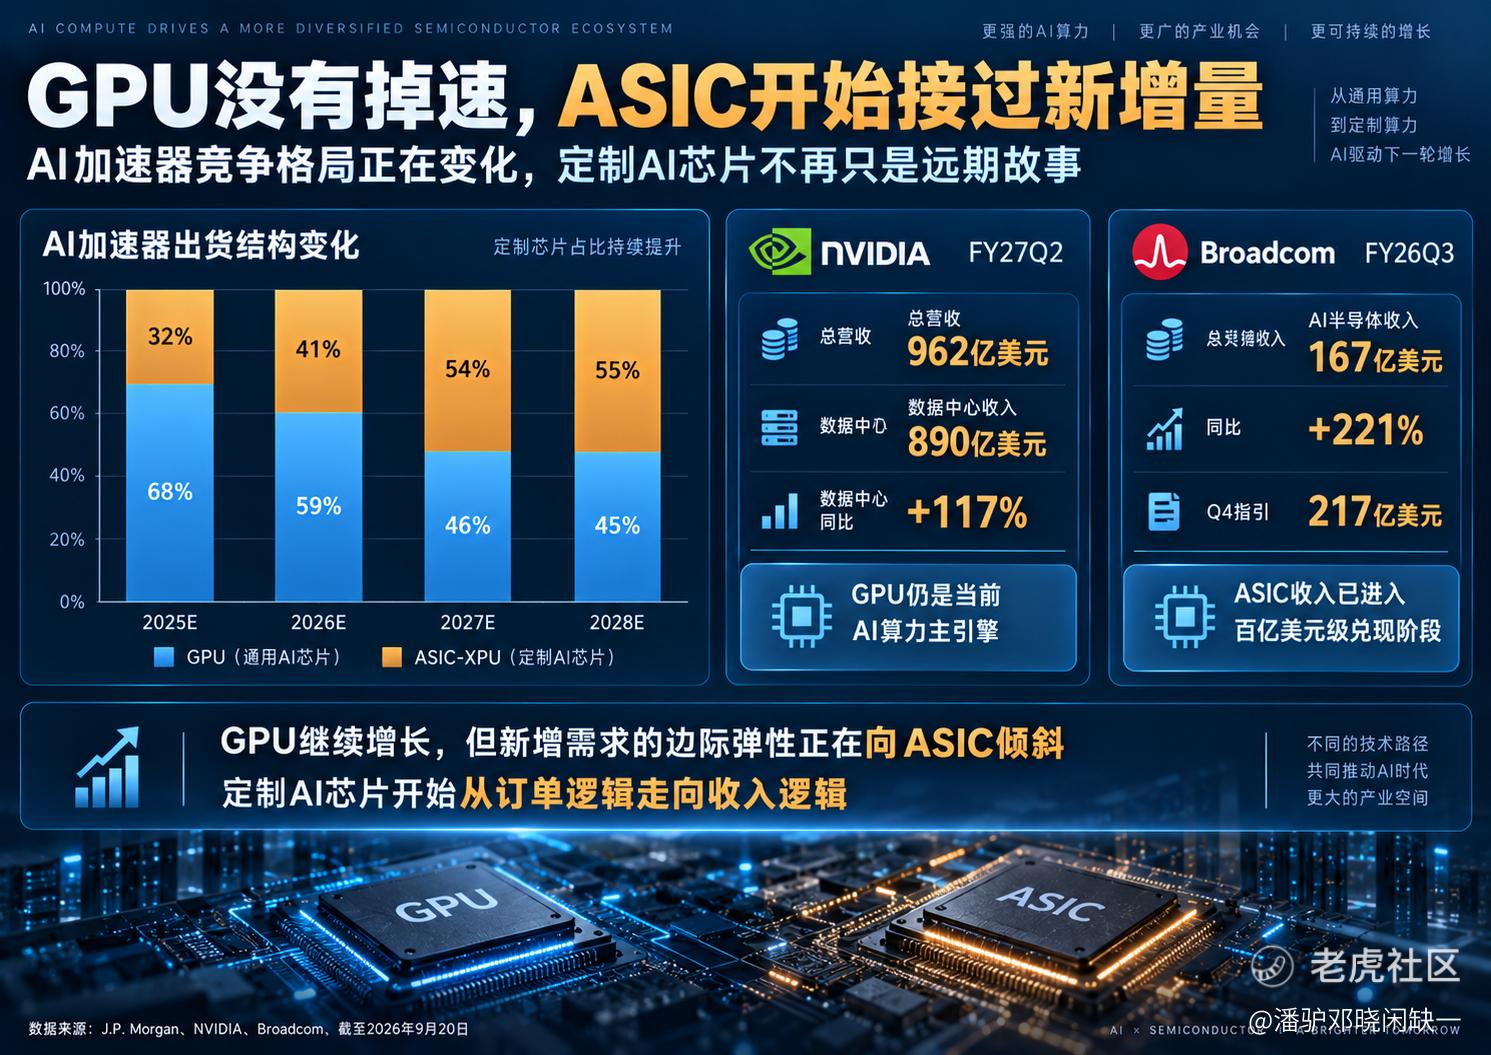
摩根大通预测,按AI加速器出货量计算,ASIC/XPU占比将从2025年的32%升至2026年的41%,2027年进一步达到 54%;GPU同期占比由68%降至46%。
这里需要区分出货量与市场价值。GPU单颗售价、平台价值以及软件生态仍显著高于多数定制芯片,54%的单位占比并不等于ASIC收入超过GPU。
产业变化发生在另一层:Google、Meta、Amazon、Microsoft以及前沿模型厂商都在增加定制芯片投入。Hyperscaler希望降低单位推理成本、功耗和对单一通用GPU供应体系的依赖,ASIC因此获得了一条独立于GPU增长的需求曲线。
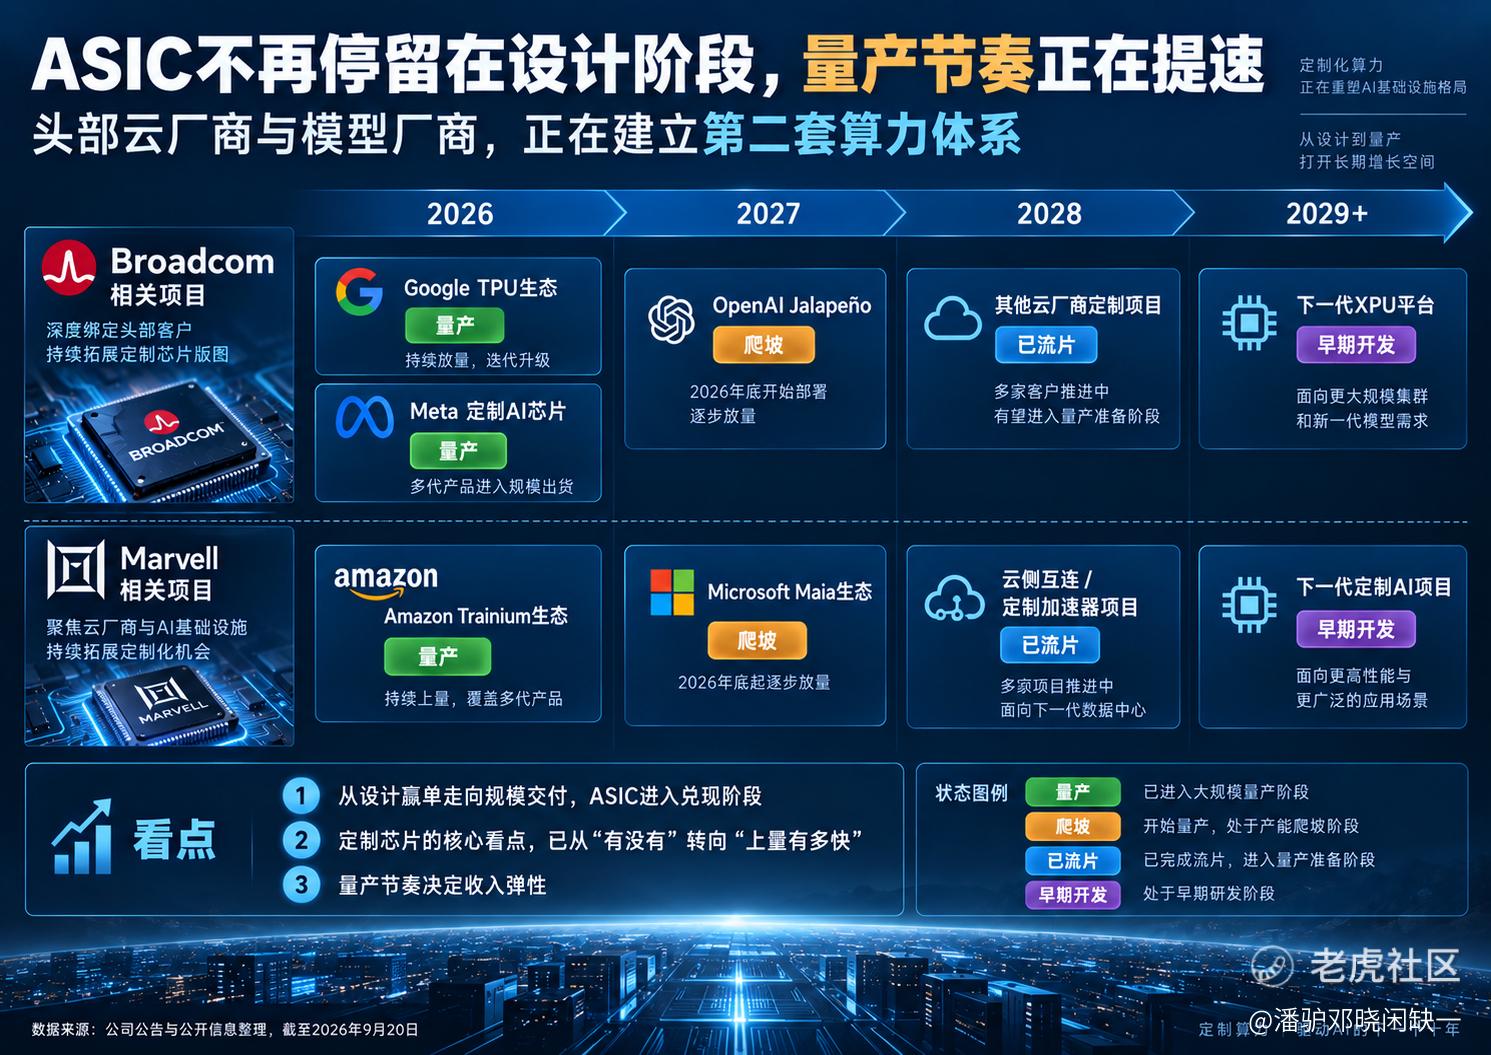
Broadcom与Marvell的差别也越来越清楚。Broadcom掌握更多头部XPU项目,并同时覆盖交换芯片、SerDes和先进封装;Marvell的收入基数较小,但在Trainium、Maia以及SmartNIC、CXL、光互连等配套环节具备更高的增量弹性。ASIC这一阶段已经不缺项目,接下来决定盈利斜率的是 量产时间、客户部署规模和先进封装供给。
三、HBM之后,高容量服务器内存开始接棒
存储是另一条已经从单点扩散的链。Micron FY26Q3披露,HBM4已经进入高量出货,HBM4E预计2027年进入量产;同时,公司已经向关键服务器生态客户送样256GB DDR5 RDIMM。
SK hynix在2Q26也开始HBM4量产出货,并披露正在与约10家关键客户推进长期供应协议。公司对需求结构的描述已经从单一HBM,扩展到高价值DRAM与NAND。
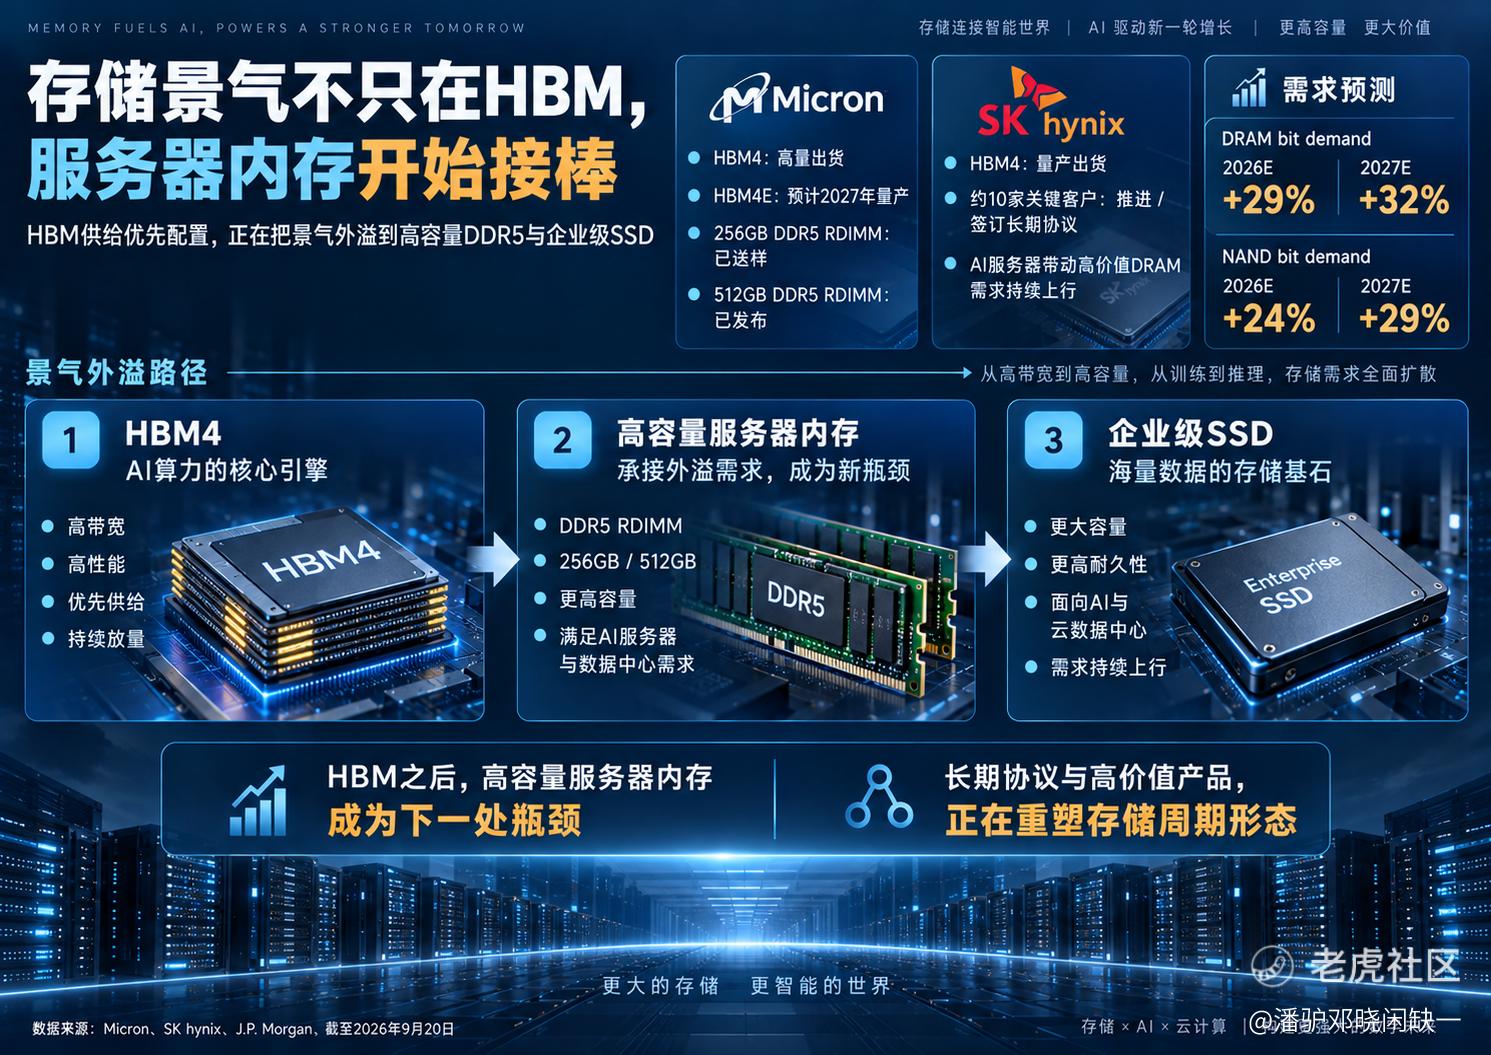
AI服务器的内存瓶颈正在向两端扩散。一端是高容量DDR5,模型参数、上下文长度以及内存数据库对CPU侧容量提出更高要求,256GB、512GB RDIMM开始进入新一轮服务器平台验证和部署;另一端是企业级SSD,训练数据、推理缓存和Agent工作流增加数据读写量,NAND需求逐渐从消费电子恢复转向数据中心驱动。
摩根大通预计,2026年DRAM位元需求增长 29%,2027年进一步增长 32%;NAND同期分别增长 24%和 29%,其中企业级SSD是主要驱动之一。
这一轮存储周期还有一个与过去不同的变量:长协。DRAM和NAND厂商开始通过长期供应协议提前锁定价格和供货量。HBM占用更多先进DRAM产能,加上原厂资本开支仍保持纪律,供给端很难在短时间内复制过去那种无序扩产。观察存储周期只看现货价已经不够,产品结构、长期合同和新增晶圆产能,正在决定这一轮盈利能够维持多久。
四、设备开始兑现:AI已经走到制造环节
如果芯片设计公司的收入代表需求,那么半导体设备公司的收入代表产能开始落地。
Lam Research截至6月的季度收入 67.22亿美元,环比增长15.1%,下一季度收入指引升至约81亿美元。Applied Materials FY26Q3收入 91.2亿美元,同比增长25%,创季度纪录;公司同时上调了对2026年半导体系统业务的预期。
KLA FY26Q4收入36.6亿美元,并给出FY27Q1约40亿美元、上下浮动2亿美元的收入指引。公司明确把先进逻辑、存储复杂度和先进封装列为需求来源。
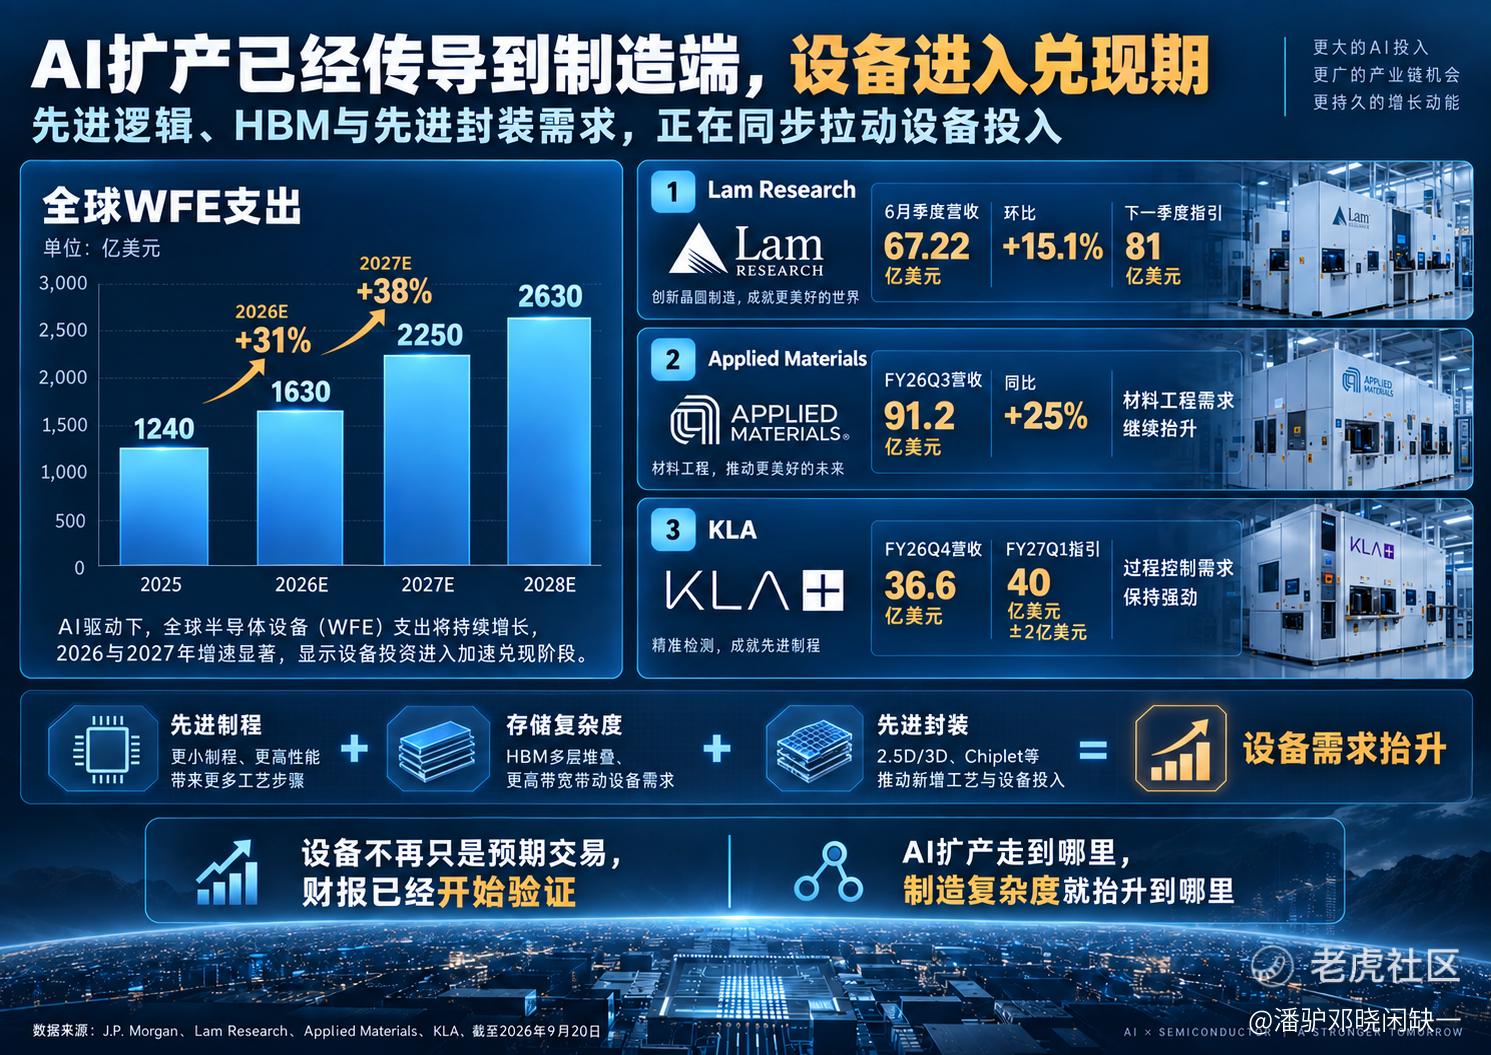
摩根大通预计全球WFE支出从2025年的 1240亿美元升至2026年的 1630亿美元,2027年达到 2250亿美元,2028年进一步升至2630亿美元。2026和2027年对应增速分别为31%和38%。
设备环节的关键并不只是晶圆数量增加。2nm、3nm工艺需要更多沉积、刻蚀和量测步骤;HBM增加高深宽比刻蚀、键合和检测需求;2.5D/3D先进封装继续拉长制造流程。芯片越复杂,每片晶圆背后的设备价值量越高。2026年的设备行情已经逐渐从“未来扩产”切换到“订单与收入兑现”。
五、同一条AI主线,估值已经明显分层
产业趋势同时向上,不代表估值处在同一个位置。按摩根大通9月16日的2027E一致预期口径,NVIDIA约14.2倍PE,Broadcom约16.6倍,Marvell约35.6倍;Micron约5.5倍;Applied Materials约21.4倍,Lam Research约25.7倍,KLA约27.8倍。
这些数字不能机械横比。Micron的低PE来自存储利润处在强上行阶段,周期利润越高,静态估值越低;Marvell的估值明显更高,市场已经提前计入2027—2028年ASIC和数据中心业务的放量;设备股介于两者之间,估值依赖WFE上修能否继续转化为收入和EPS。
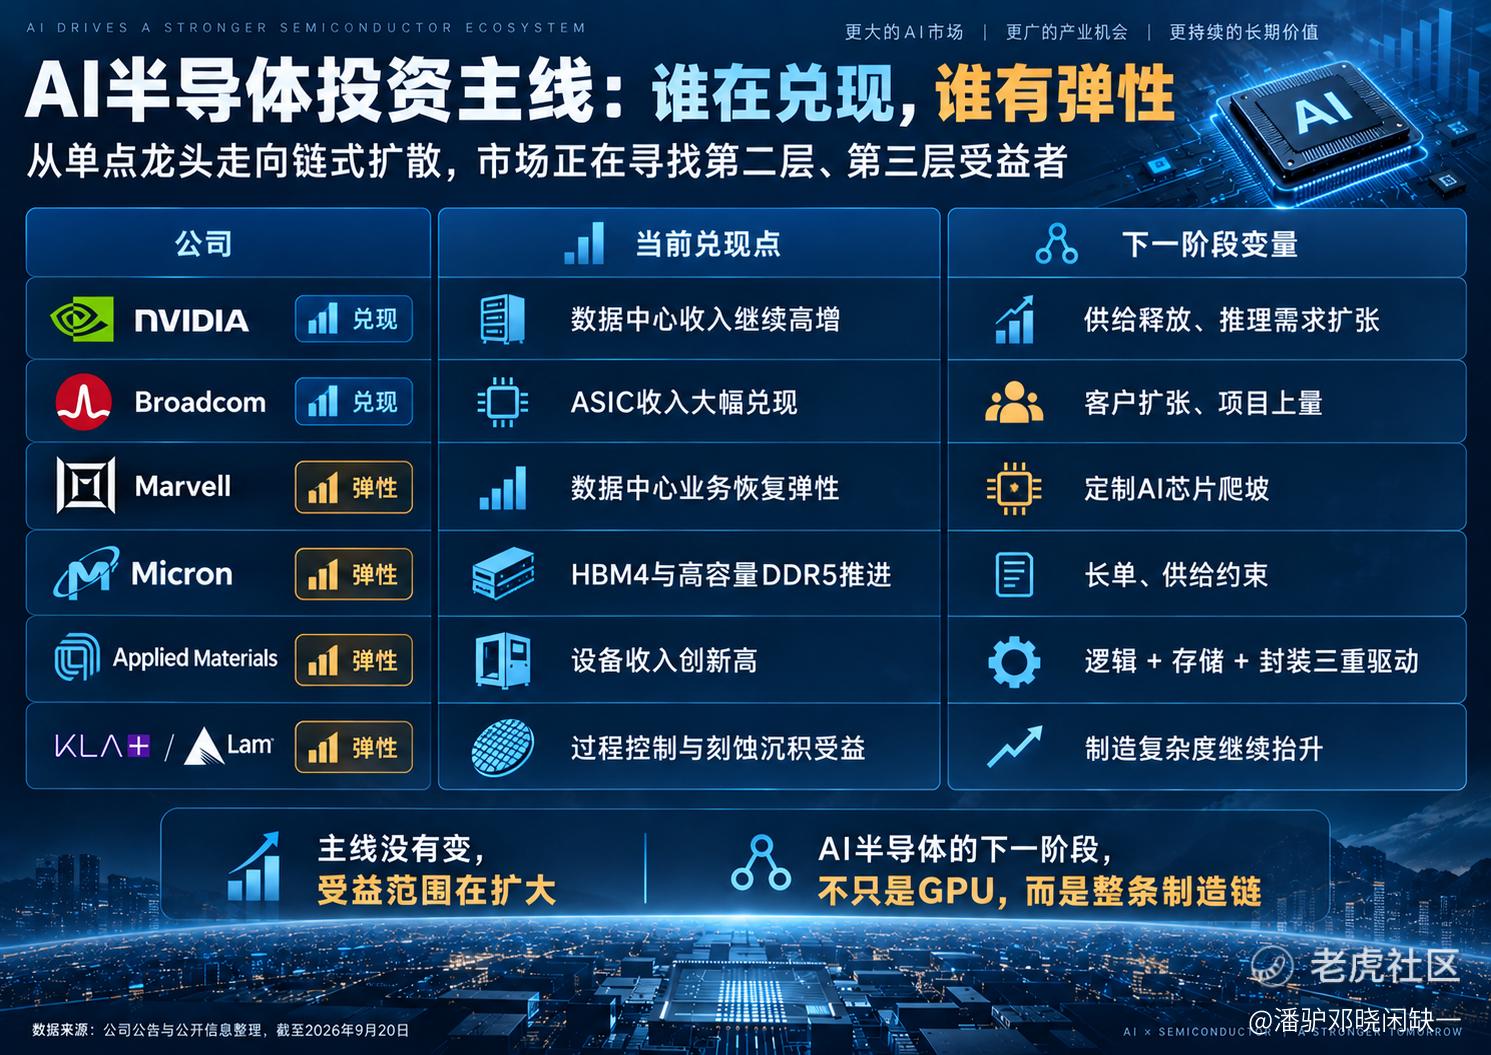
从盈利兑现顺序看,目前可以分成三层:第一层是已经形成大额利润的算力核心,NVIDIA、Broadcom的AI收入已经达到足够大的基数;第二层是收入弹性更大的ASIC与存储,Marvell、Micron的利润斜率更依赖产品爬坡和供需缺口;第三层是制造端,Applied Materials、Lam、KLA受益于先进制程、DRAM/HBM和先进封装同步扩产。
风险也比一年前清楚:云厂商Capex一旦高位降速,ASIC项目延期,存储供给释放过快,或者设备订单提前透支,都会迅速打断盈利上修。
截至9月20日,公开财报给出的信号仍偏强: GPU继续增长,ASIC开始确认大额收入,服务器内存进入新一轮产品升级,设备公司的订单和收入已经接上。 对这一阶段的AI半导体而言,值得看的已经不是“下一只英伟达是谁”,而是哪一段产业链的盈利上修还没有被估值完全消化。
风险提示: 本文仅用于行业与公司基本面研究交流,不构成任何投资建议、证券推荐或收益承诺。文中涉及的预测数据、估值与产业链判断可能随公司经营、行业供需、宏观环境及市场预期变化而调整,投资者应基于自身风险承受能力独立决策。
精彩评论