英伟达CEO黄仁勋最近在苏格兰说了一句很重的话:AI继续进入医疗、制造、金融等行业,英伟达明年的芯片销量可能达到今年的两倍。
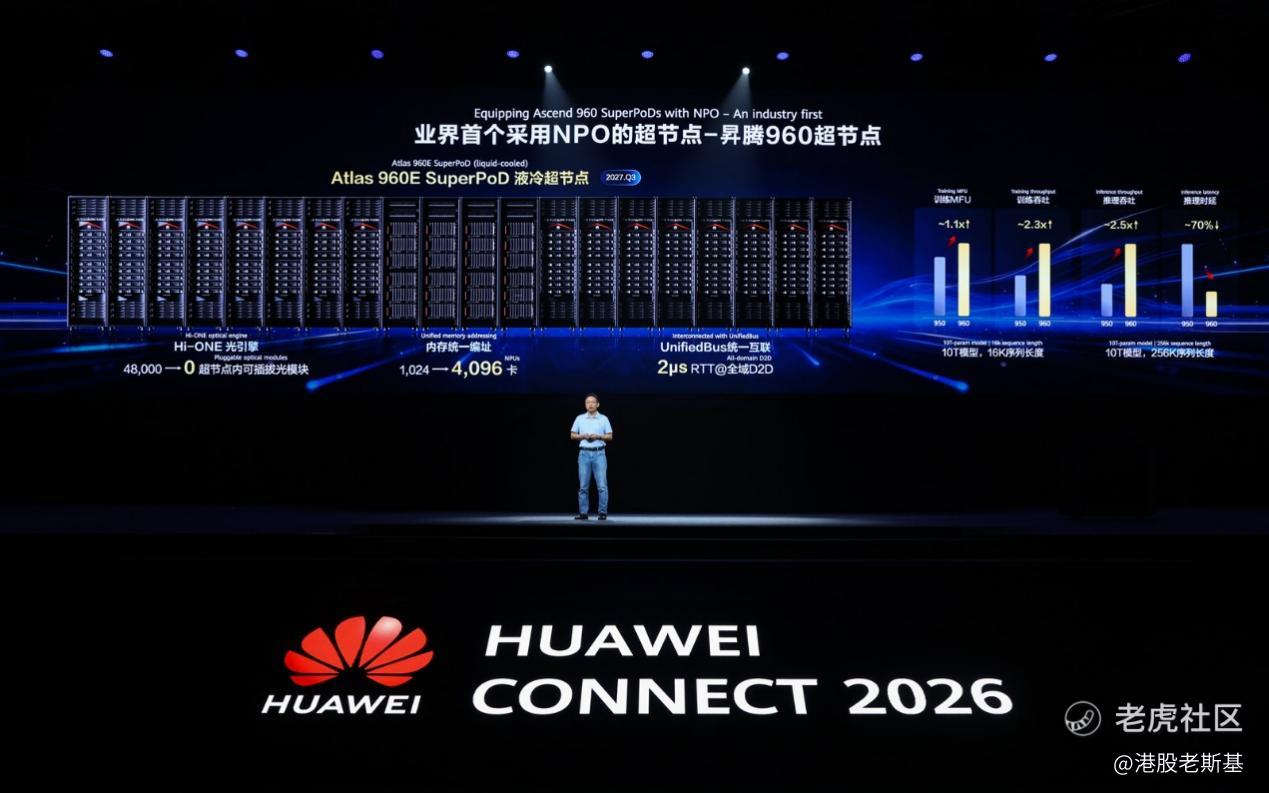
而就在他说这句话的前几天,上海**全联接大会上,全球首个采用NPO技术的**960超节点亮相,单个系统最高支持4096卡,直指十万亿参数模型的训练和推理,标志着中国AI基础设施正式迈入全球第一梯队。
在全球AI算力市场,英伟达长期占据主导地位。其DGX GB200系统单机柜可提供1.4 EFLOPS FP8算力,通过NVLink连接多个机柜可构建更大规模的集群。
**960的发布,使国产算力首次在单系统规模上实现与国际顶尖水平的并跑甚至领跑:
·算力密度:**960单节点8 EFLOPS,远超传统集群架构
·内存容量:1 PB HBM统一内存,为大规模模型训练提供充足空间
·扩展能力:支持构建百万卡级超大规模集群
值得注意的是,**在发布会上特别强调,**960并非实验室概念产品,而是已经具备量产条件、将于2027年Q2-Q3正式上市的商用产品。
黄仁勋敢喊翻倍,说明算力需求仍在爆发;**960亮相,标志着国产算力迈入全球第一梯队,国产算力已经崛起。同时需求爆发之下,算力的组织方式正在生变,价值会沿着整条系统链重新分配。
一、销量翻倍与4096卡,指向同一轮算力扩张
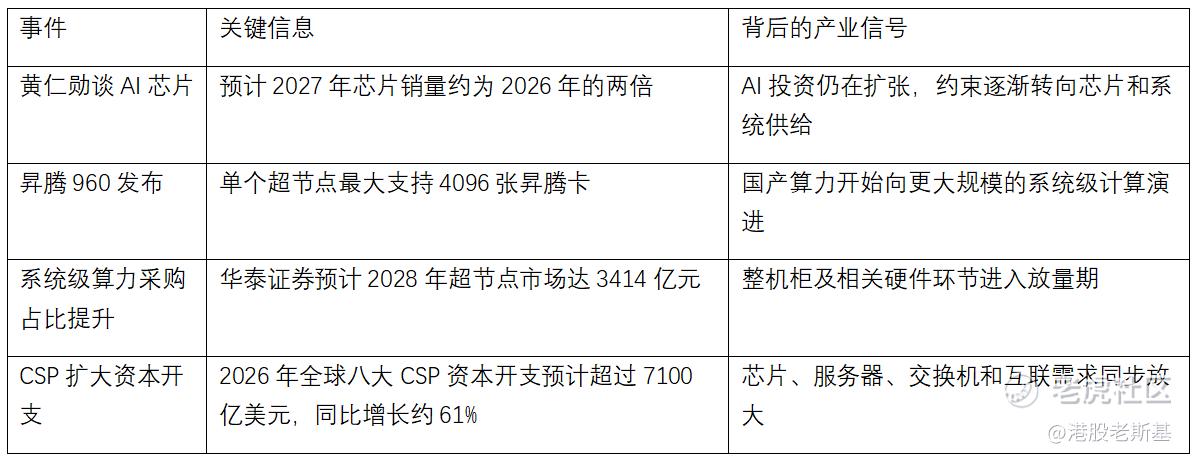
从芯片销量到资本开支,几组数字指向同一轮扩张:行业还在爆发,需求远未见顶。
需求越旺,瓶颈越明显。模型参数越大,训练要在更多芯片间同步数据;推理走向长上下文和Agent,一次调用跨多轮计算。集群堆到几千卡以后,通信延迟、内存访问、故障率快速放大,互联跟不上,新增算力会被系统损耗吃掉。单卡再强,也装不下整个模型。
那什么是超节点?简单说,就是把成百上千张算力卡,用高速互联、统一内存和液冷机柜组织成一套协同计算的系统,让几千张卡像一张卡一样工作。
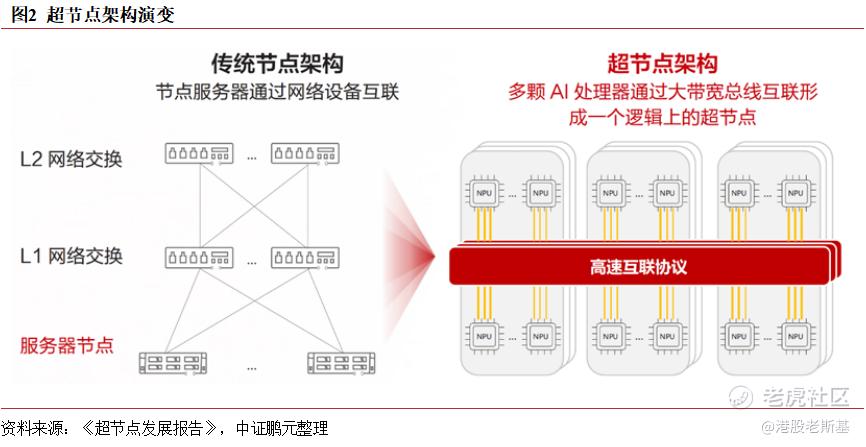
大模型越做越大,单卡算力已经不够用。真正卡住训练和推理效率的,开始变成多卡之间的通信、调度、供电、散热和整机稳定性。超节点要解决的,就是把几百张甚至上千张AI芯片,组织成一个高效率的统一计算系统。
所以,超节点不是简单堆服务器,而是AI算力基础设施的一次系统升级。
超节点的难点,也正是在这里。
要在极高功率密度下,把计算节点、网络节点、供电系统、液冷散热、高速互联和整柜结构做成一个稳定协同的整体,早就不是把服务器一台台摆进机柜那么简单了。
任何一个环节出问题,都会影响整套算力系统的效率和可靠性。
因此,这对整机厂商提出了很高要求:既要懂服务器架构,又要懂高速互联;既要解决散热和供电,还要保证批量制造中的一致性、测试效率和交付稳定性。
二、超节点放量,产业价值向哪些环节扩散?
计算节点越多,对交换带宽、高速连接和散热的要求越高,价值量也会沿着整条系统链重新分配。
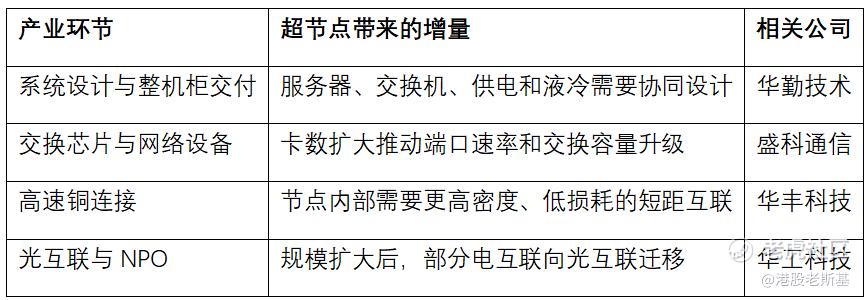
四家公司所处的位置不同,受益逻辑也有先后。华勤承接系统交付,盛科通信提供网络底层芯片,华丰科技解决设备内部的高速电连接,华工科技则面向更高速率、更远距离以及NPO、CPO等光互联方向。
华勤技术:稀缺的全栈能力+确定性
国内领先的智能硬件产品平台型企业,是国内极少数具备"计算+网络+液冷"全栈设计能力的智能硬件厂商。超节点考验的是全栈能力,华勤已经卡在国产算力从“能用”走向“规模交付”的关键环节。同时是阿里、腾讯、字节跳动等国内头部CSP核心供应商,英伟达高端AI芯片的重要ODM合作伙伴。
公司披露,超节点三季度进入批量出货,全年预计超100亿元;交换机全年收入预计约60亿元。
盛科通信:交换芯片跟着网络密度升级
超节点规模扩大,首先增加的是节点之间的通信流量。训练和推理过程中,算力卡需要频繁同步参数,交换网络的延迟和拥塞会直接影响有效算力。
盛科通信是国内少数具备高端以太网交换芯片研发能力的厂商。公司在研高性能核心交换芯片支持最高800G端口,并面向大规模数据中心提供低时延、可编程和可视化能力。
华丰科技:高速铜连接进入价值量提升阶段
华丰科技已经形成从I/O端口到芯片侧、从计算节点到交换节点的全链路连接方案。公司披露,其224Gbps高速背板连接器和高速线模组已在AI算力集群实现工程化应用,产品可适配国产AI服务器及超算集群。
超节点卡数越多,内部高速连接数量和密度越高。华丰科技的看点正在于产品速率提升与集群放量能否同步转化为订单规模。
华工科技:NPO把光互联推向节点内部
NPO是**960最值得注意的技术变化之一。华工科技已经形成800G、1.6T高速光模块产品,并布局3.2T NPO、CPO光引擎以及400G/lane解决方案。2025年,公司光联接业务收入60.97亿元,同比增长53.39%,800G硅光LPO和1.6T产品进入规模交付。
精彩评论