伯恩斯坦9月21日在硅谷连续见了11家公司:博通、英伟达、英特尔、恩智浦、应用材料、Monolithic Power Systems、Astera Labs、莱迪思、格芯、安霸和Lightmatter。
公司横跨计算、设备、代工、互联、电源和边缘AI,聊出来的时间表却很集中——2027—2028年。
博通在谈OpenAI、Anthropic和Meta的定制AI芯片收入;Astera把UALink部署放到2027年、收入贡献放到2028年;Lightmatter的近封装光学也是2027年客户测试、2028年放量;MPWR认为800V数据中心供电更可能在2027年末或2028年进入实质收入期。应用材料更早一步,已经按照2028年的需求准备把季度产出能力做到当前的两倍。
过去两年AI硬件最肥的一块利润集中在GPU、HBM和高速网络。现在资金没有离开这条主线,只是顺着一台AI服务器继续往外走:定制芯片、晶圆设备、DRAM、先进封装、电源和Scale-up互联,开始同时吃到增量。
ASIC已经从“客户名单”走到收入曲线
博通这场交流的信息最密。
Google仍然是定制AI芯片的基本盘,Broadcom继续参与2027年的Sunfish,并预计后续世代仍会参与。但管理层花更多篇幅谈的是Google之外的客户。
Anthropic对应的是一块独立的5GW需求;OpenAI正在把Jalapeño路线往前拉,部署节奏快于博通当前预测;Meta依然以2028年为主要收入年份,2027年末可能先贡献一部分。
博通当前AI收入展望已经做到2027年约1150亿美元、2028年约2300亿美元。公司同时提到,这里面已经考虑了客户GW计划最终能兑现多少;如果规划中的算力全部落地,收入还有向上的空间。到2028年,OpenAI和Anthropic任何一家给博通带来的业务体量,都有可能做到与Google相当甚至更大。
这里开始出现一个很有意思的变化:客户需求已经不是博通最头疼的事。
2027年的数据中心物理站点基本已经完成,2028年的站点规划也足够清楚。限制收入速度的东西开始变成电力、晶圆和存储。
台积电仍然是核心晶圆代工伙伴,短期很难切换;存储由博通直接参与采购,现有合同覆盖到2029年前后;先进封装则开始自己补能力。
博通正在马来西亚建设面向自家定制芯片客户的封装产能。管理层举的例子很直观:今天一个封装可能只有2颗裸片,下一代变4颗,后面可能走到16颗。它不会取代CoWoS,而是在XPU越来越复杂以后,把一部分封装能力掌握在自己手里。
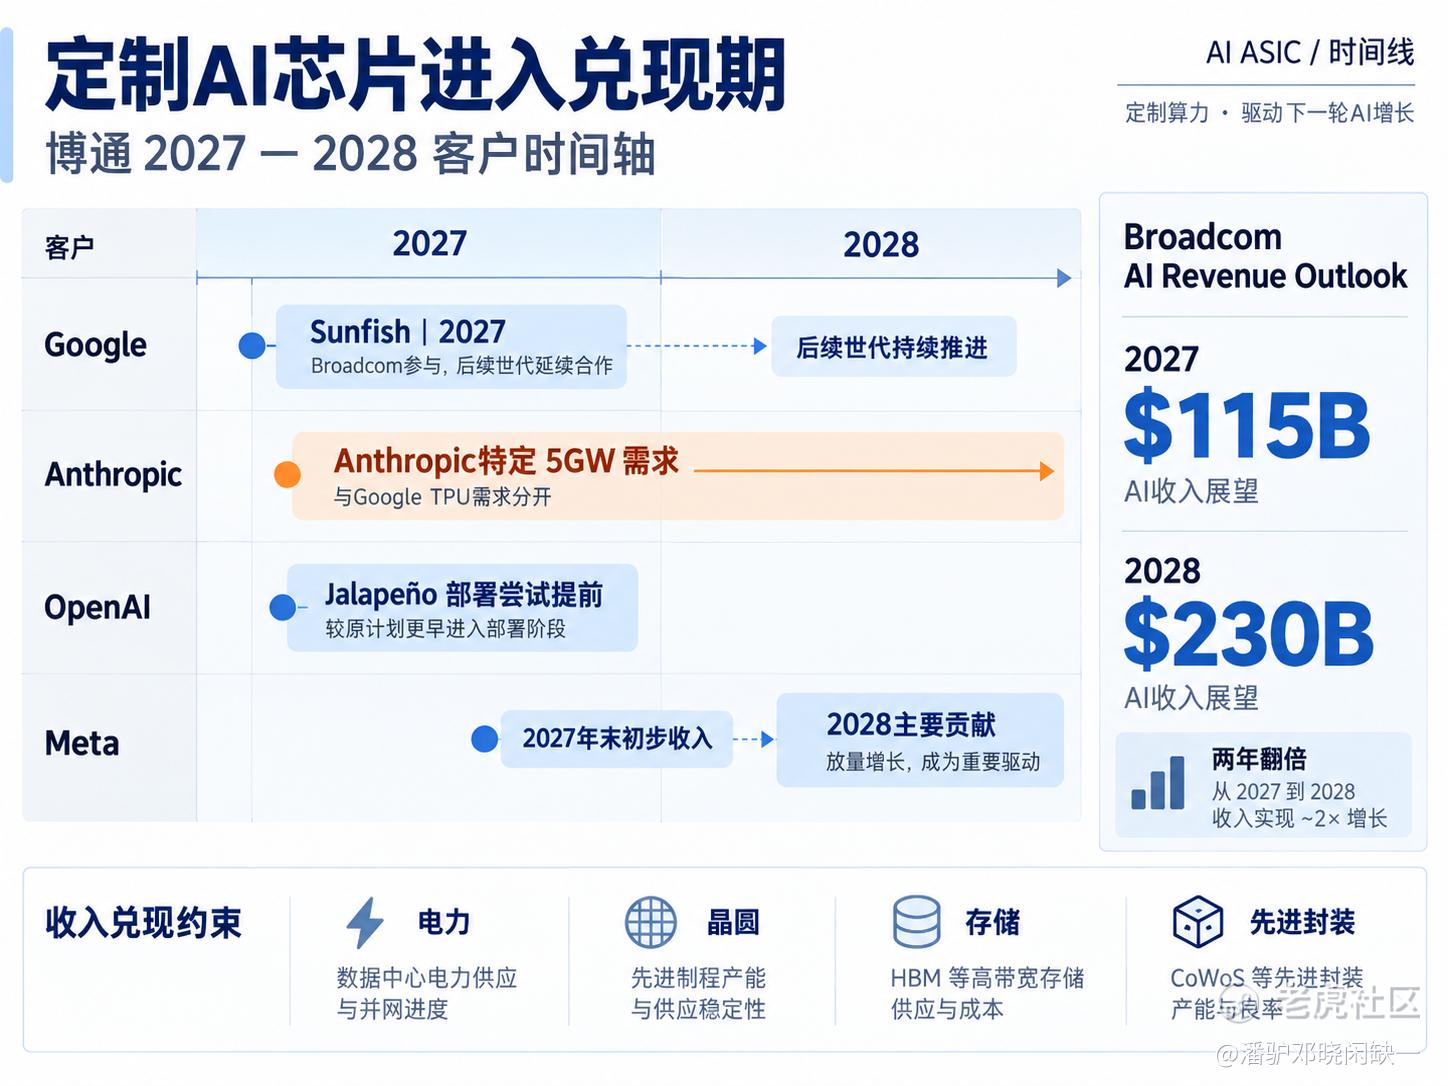
图1|定制AI芯片进入兑现期:博通2027—2028客户时间轴
英伟达面对的是同一个市场,判断却完全不同。
管理层并不否认ASIC在固定工作负载里的效率优势,但它认为AI模型、软件和推理方式还远没有稳定下来,可编程GPU的价值仍然很高。
一个数据很能说明问题。
ChatGPT出现以前,英伟达收入大约相当于超大规模云厂商公开资本开支的5%;之后升到约20%,最近已经到了20%中段。同期Google TPU和各类自研ASIC一直在增加,但英伟达从云厂商资本开支里拿走的钱反而越来越多。
原因已经不只是一颗GPU。
把CPU、网络和其他系统级器件算进去,英伟达给出的数据中心内容价值已经接近400亿美元/GW。它正在把自己的生意从芯片往整套计算平台延伸。
因此,GPU和ASIC眼下还不需要分个输赢。AI资本开支足够大,两套架构可以同时增长。
对于产业链,这种并行反而更值钱:芯片架构越多,封装越复杂,网络带宽越高,存储、电源、SerDes和交换芯片的需求都会跟着上去。
算力继续堆,设备、封装和电源开始变贵
应用材料的数字已经明显脱离普通半导体上行周期的节奏。
今年2月,公司还在预计半导体系统业务增长超过20%;5月提高到超过30%;8月已经变成约40%。
进入2027年,管理层仍然看强。新增晶圆厂设备需求里,大约80%来自先进逻辑、DRAM和先进封装。
公司正在为2028年扩产,目标是把季度产出能力做到现在的两倍。按应用材料现有市场份额倒推,这套产能足以服务一个大约3000亿美元规模的晶圆厂设备市场。这里更值得看的是产能准备程度,而不是把3000亿美元直接当成行业预测——同期华尔街对2028年WFE市场的预期仍在2500亿—2600亿美元附近。
应用材料现在碰到的约束甚至不全在自己厂里。公司正在跟踪全球100多座晶圆厂项目,DRAM新产能尤其集中。一些客户洁净室的建设速度跟不上设备需求,管理层直言,如果没有洁净室限制,收入可以长得更快。
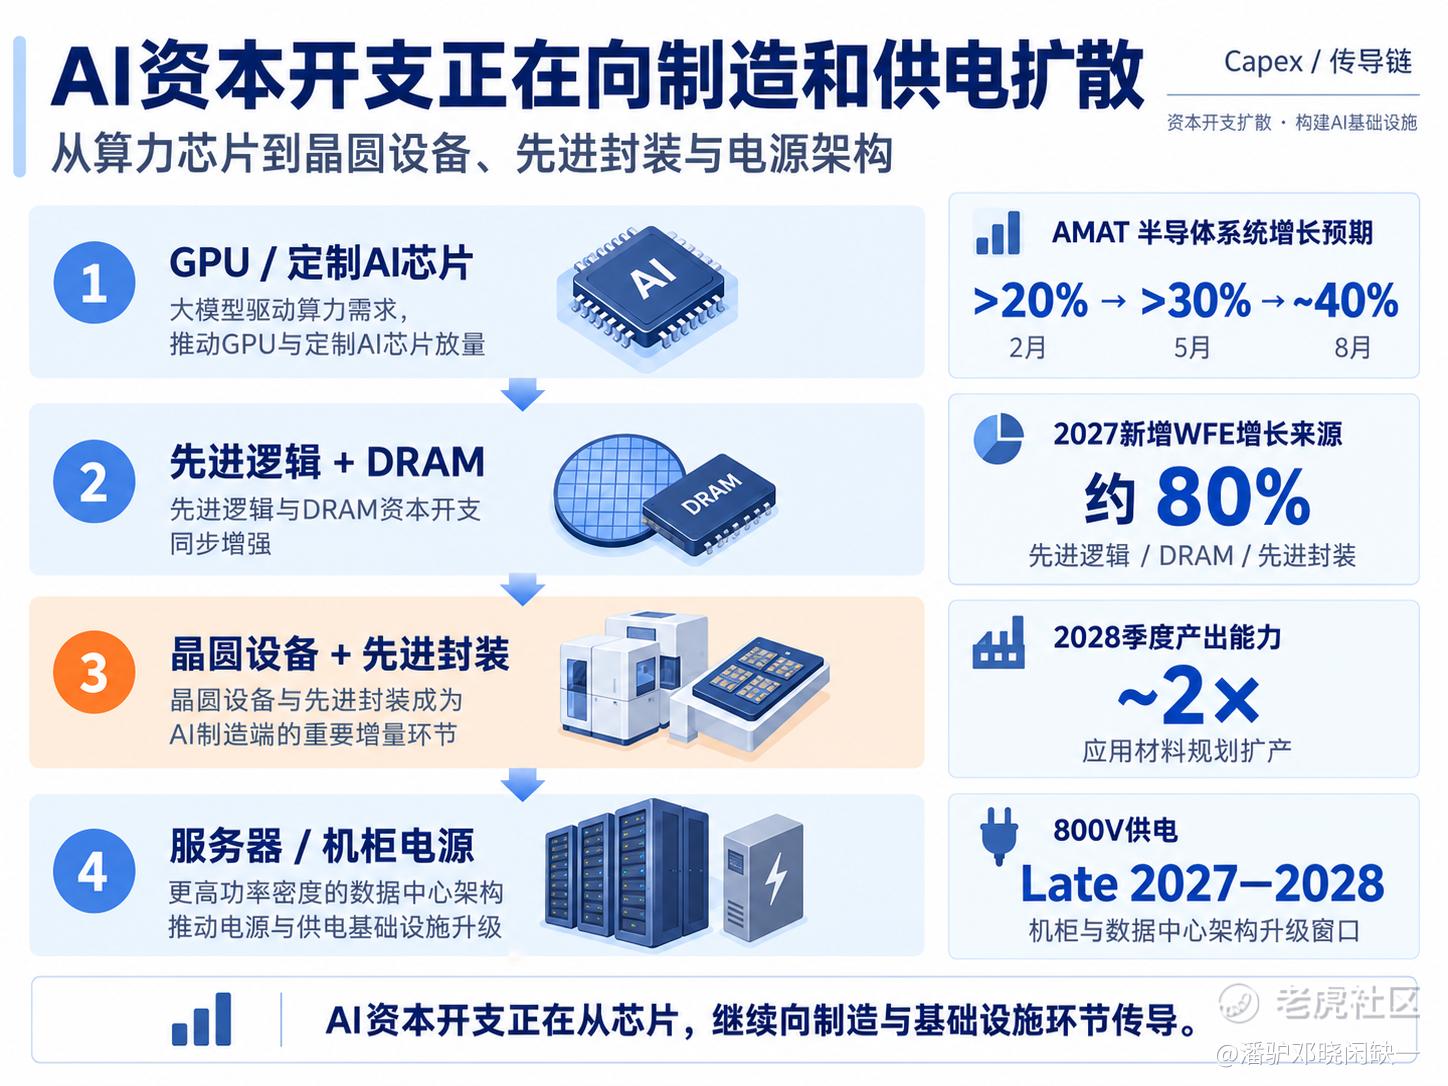
图2|AI资本开支向制造、先进封装与供电扩散
DRAM本身也越来越“像逻辑芯片”。传统DRAM大约60%的面积是存储阵列,40%属于晶体管和外围电路。随着FinFET、4F²单元以及未来3D DRAM逐步导入,材料工程、沉积和高深宽比加工都会增加。
以前一轮新制程往往是手机先走,高性能计算跟上,汽车最后。AI把这个节奏打乱了。GPU、定制ASIC、DRAM和先进封装同时演进,设备厂面对的是几条资本强度上升的工艺路线叠在一起。
应用材料的集成系统业务,占半导体系统收入的比例已经从几年前约20%提高到30%左右。一些先进互联工艺过去4个步骤就能做完,现在可能要6—7个连续沉积、清洗和材料处理步骤。
工艺越复杂,设备商出售的就越接近一套工艺平台,而不是单台设备。
电源也在发生类似变化。
MPWR表示,企业数据中心仍是增长最快的业务,通信已经成为第二大增长来源,主要需求来自交换机、DPU和光网络设备。
机柜功率往上走以后,集成式电压调节器、模块化电源以及高压直流供电的价值都会提高。现在讨论很多的800V数据中心供电,管理层并没有把收入节点放得很近:第一阶段仍然是把800V降到中间电压,真正更大规模的机会更偏向2027年末或2028年。
当AI数据中心做到GW级,电力已经不是后台成本问题。功率密度继续增加以后,几个百分点的转换效率都能直接影响数据中心经济性。
互联开始成为下一笔大额硬件预算
单颗GPU继续变快,并不能自动解决十万颗加速器一起工作的效率问题。
Astera Labs已经从PCIe信号重定时器,走到了PCIe交换、CXL内存、UALink和NVLink Fusion。公司现在有两个NVLink Fusion项目在推进。
传统服务器仍然有市场,但管理层认为AI基础设施里的互联内容价值可以比传统服务器高出一个数量级。Scale-up架构越复杂,每颗加速器周围需要的连接芯片越多。
UALink的节奏已经很清楚:2027年开始部署,2028年出现更有意义的收入。
Astera同时在往光互联扩。公司判断,铜和光会共存很多年。NPO近封装光学大约2027年前后开始出现,CPO共封装光学因为成本和供应链问题,还要更往后。
博通甚至更愿意给铜一些时间。
目前Google的Scale-up网络里,大约80%的连接仍然是铜。400G级SerDes还能延长铜在AI机架内部的使用周期——成本更低、延迟更小、功耗也有优势。距离拉长以后,Scale-out网络才更多转向光。
CPO真正进入Scale-up主流,博通给出的时间已经靠近2028—2029年。
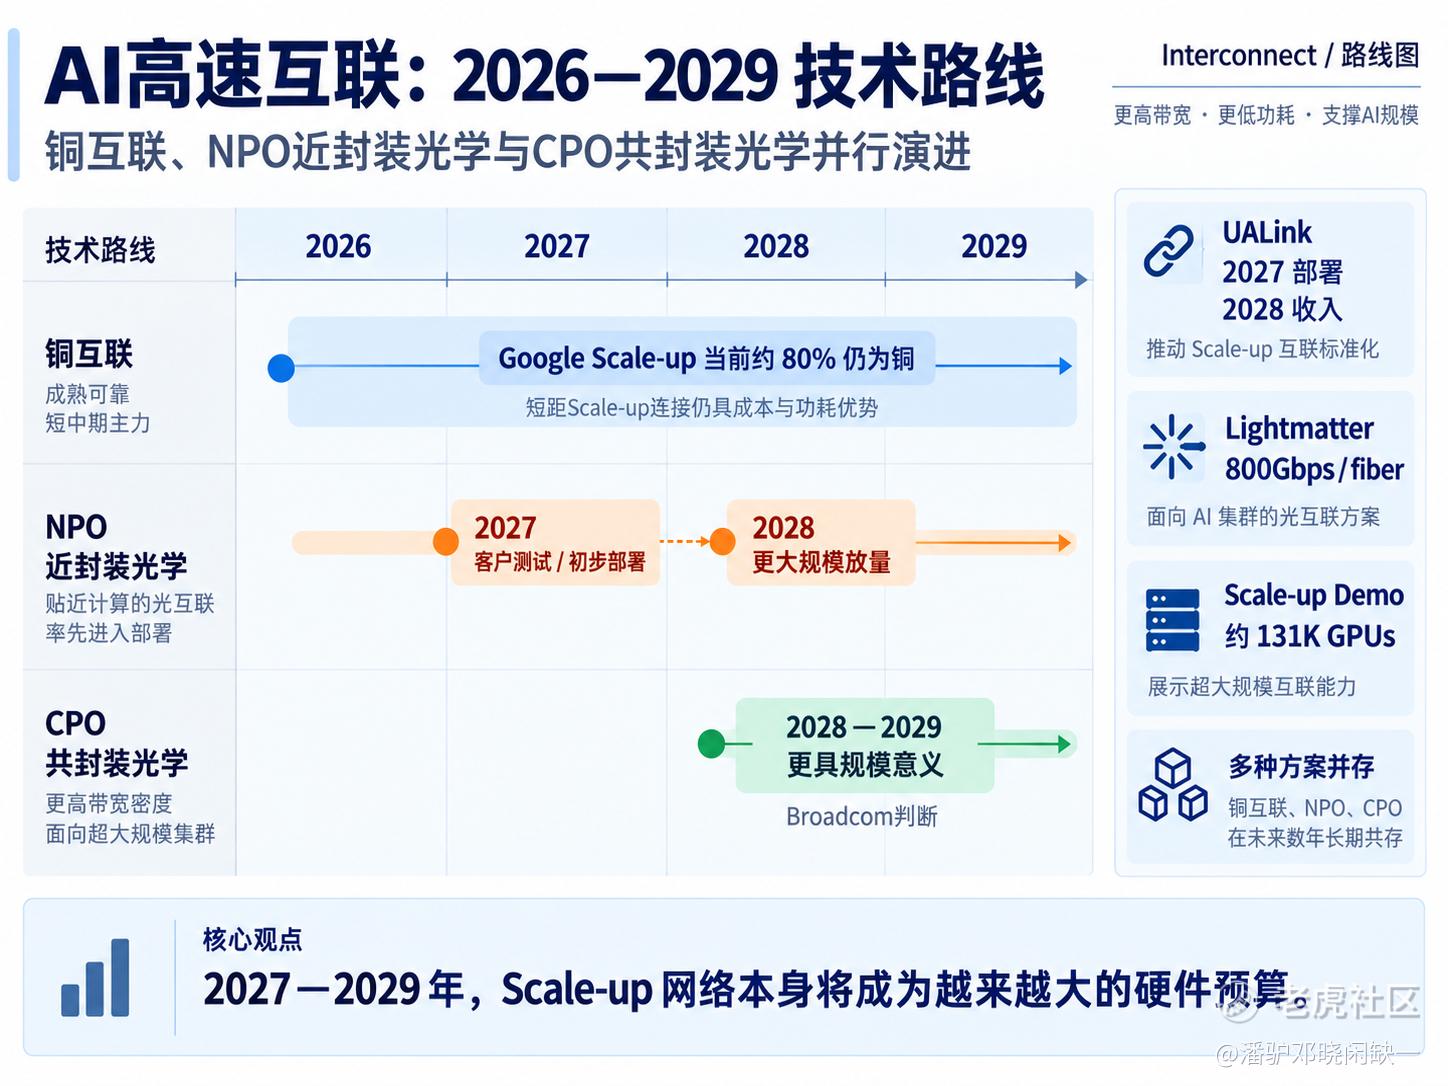
图3|AI高速互联:2026—2029技术路线
Lightmatter把这件事讲得更加工程化。
公司已经在一根双向光纤上跑出16个波长,总带宽达到800Gbps,上下行各400Gbps;同时展示过大约13.1万颗GPU规模的Scale-up域。
它的Guide Laser采用300毫米晶圆方案,一颗芯片可以集成128个激光器和16个光波长。目的很简单:GPU数量可以快速增加,但物理光纤数量不能照着GPU数量一起线性膨胀。
Lightmatter当前最看重的是NPO。客户测试预计从2027年开始,2028年进入更大规模放量。公司已经加入英伟达NVLink Fusion生态,也在和高通等其他计算平台合作。
所以后面的高速互联行情,不太像一次干净利落的“铜转光”。更可能是一段持续数年的混合状态:机架内铜连接继续升级,可插拔光模块覆盖更远距离,NPO逐渐靠近计算芯片,CPO则等成本、良率和供应链成熟之后再往前。
过去两年市场主要算800G和1.6T光模块。接下来,Scale-up网络本身会变成一块越来越重要的硬件价值量。
GPU之外,服务器、硅光和边缘AI也在加速
英特尔这一场有几个数据容易被忽略。
管理层预计,2027年基本能卖掉所有可以生产出来的服务器产品,供给紧张可能延续到2028年上半年。
问题还在成本。Intel 18A和Intel 3当前毛利率低于公司平均水平,18A明年的晶圆产能预计增加一倍以上。利用率、良率和规模都要往上走,制造端的利润才能跟上。
ASIC反而成了一条新的增长线。
英特尔的ASIC收入,一年前还只有几亿美元,现在已经到了大约20亿美元年化水平,管理层认为可以较快走到40亿美元左右。目前收入基本来自网络ASIC,公司已经重新把计算ASIC列入增长计划。
格芯的硅光数据更有意思。
管理层目标是在2028年把硅光做到约10亿美元年化收入。纽约工厂拥有大约30万—35万片/年的硅光可转换晶圆产能。
而且这10亿美元主要靠现有可插拔光模块需求就能支撑,并不需要押注NPO或者CPO立刻普及。光通信过去习惯把价值量拆成DSP、激光器、光模块,现在晶圆制造这层也开始单独出现规模。
莱迪思赚的是另一种数量增长。
服务器里的安全、电源时序、I/O控制和基础设施管理越来越复杂,小型FPGA跟着增加。综合服务器搭载强度从2024年的约1.5倍提高到2025年的2.5倍,2026年预计达到3.5—3.6倍。2024年一些AI机架大约使用50颗FPGA,现在部分设计已经超过100颗;如果把计算、网络、电源和散热都算进去,一套AI机架甚至可以需要数百颗。
公司预计今年服务器收入超过3亿美元,传统服务器和AI基础设施大致各占一半。
安霸则把AI带到了数据中心之外。
公司大约90%的收入已经符合Physical AI,也就是物理AI的业务定义,累计出货约5000万颗SoC,覆盖1—1000 TOPS的算力范围,已有超过200种模型架构适配到平台。
摄像头、机器人和传感器过去主要负责感知,现在开始往规划和执行走。这里不需要云端那种超大模型,更强调低功耗、本地推理和实时性。
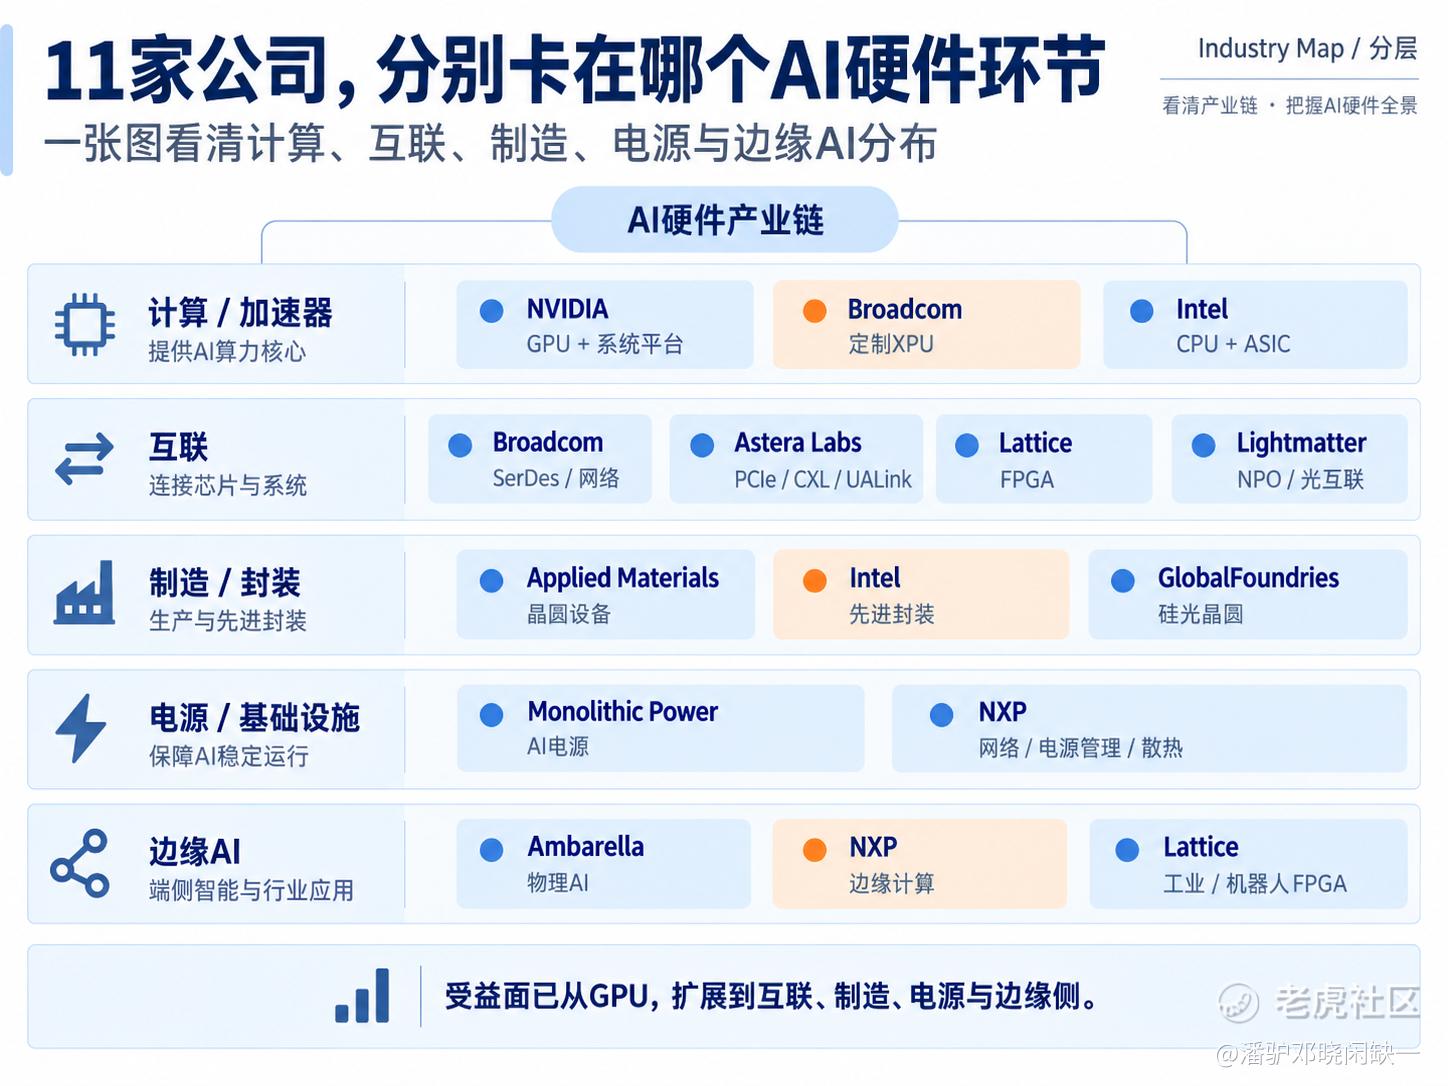
图4|11家公司分别卡在哪个AI硬件环节
11家公司放到一张产业链里,已经能看出一个比较清楚的变化:
AI的增量还在,但增量不再只写在GPU公司的损益表里。
2027—2028年,AI硬件的账会越算越长
2026年市场最容易看到的,仍然是GPU、HBM、交换芯片和设备订单。
2027年以后,多出来的东西开始变多:更多定制ASIC进入兑现,UALink开始部署,NPO进入客户测试,800V供电靠近收入期。
2028年,这些产品逐步从部署转成放量,先进封装、Scale-up光互联、电源架构在整套AI系统里的价值都会提高。CPO则更接近2028—2029年的故事。
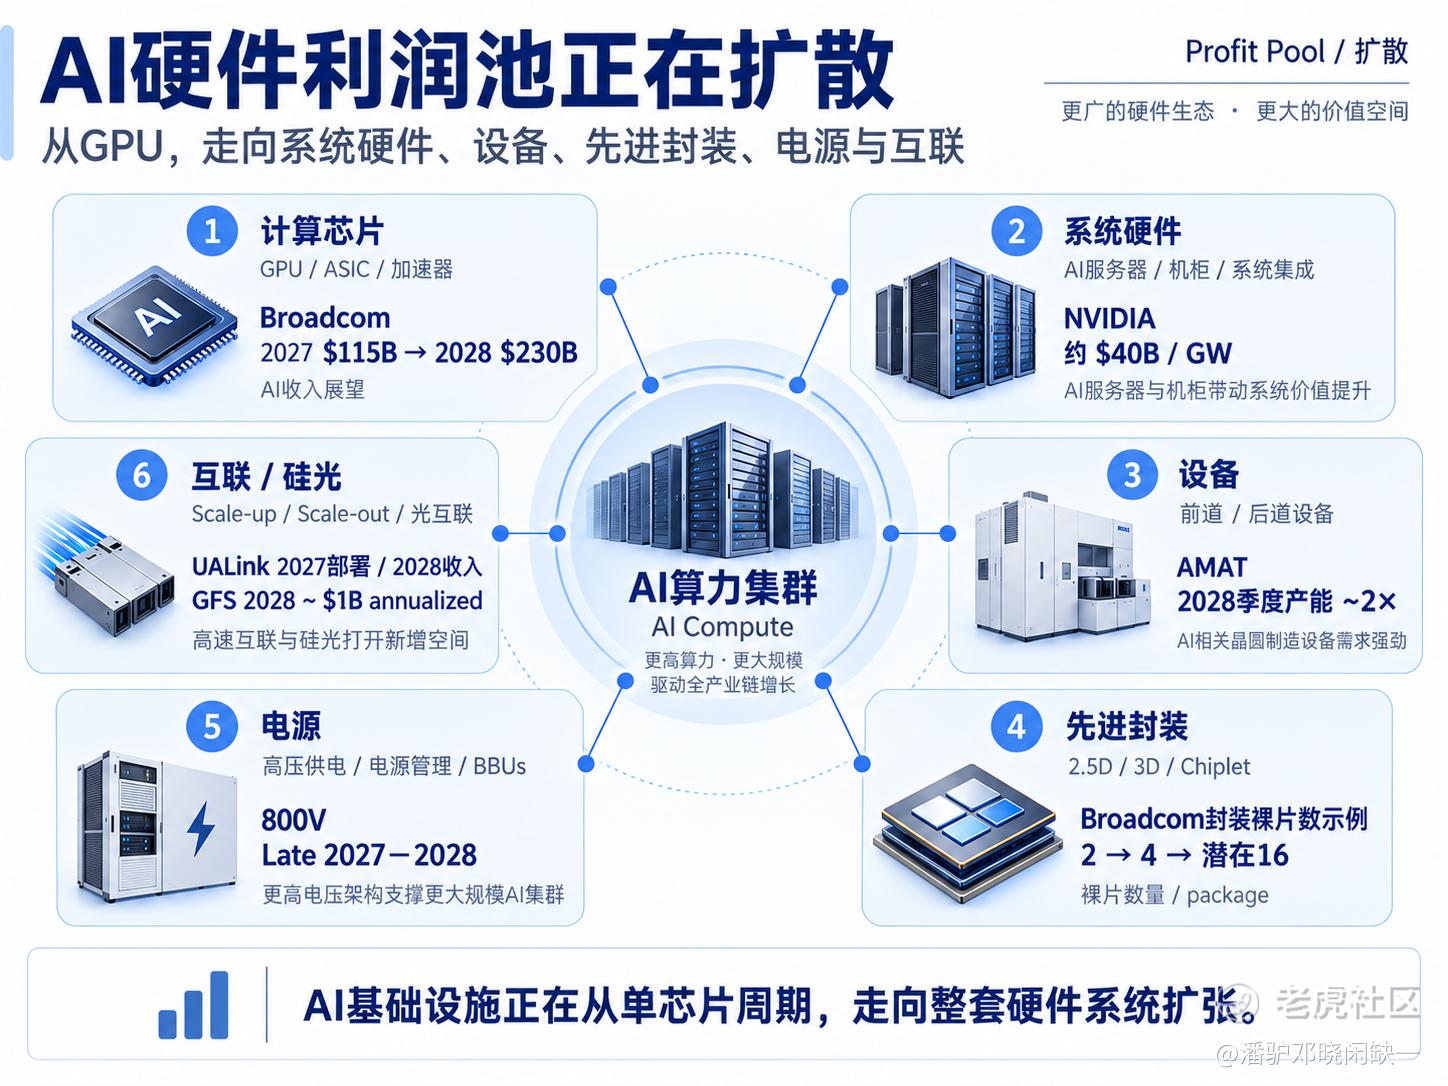
图5|AI硬件利润池正在扩散
过去两年,一座AI数据中心最好理解的一笔账是GPU数量。
后面这张BOM会越来越长。
每增加1GW算力,背后都需要更多晶圆、DRAM、HBM、先进封装、电源、交换、SerDes、铜连接和光连接。芯片数量增加是一层,系统复杂度上升又是一层。
英伟达现在讨论的是约400亿美元/GW的系统内容价值;博通已经把AI收入看到2027年1150亿美元、2028年2300亿美元;应用材料按照2028年更大的WFE需求准备翻倍产出能力;Astera、MPWR和Lightmatter又把下一轮产品时间表同时压在2027—2028年。
AI硬件的利润池没有离开GPU,只是从GPU向整套基础设施继续扩。
这应该是伯恩斯坦这轮硅谷路演里,最值得拿走的一条线索。
资料来源:Bernstein,2026年9月21日硅谷半导体管理层路演纪要。 风险提示:本文仅用于信息交流,不构成任何投资建议、证券推荐或收益承诺。市场有风险,投资需结合自身风险承受能力独立判断。
精彩评论