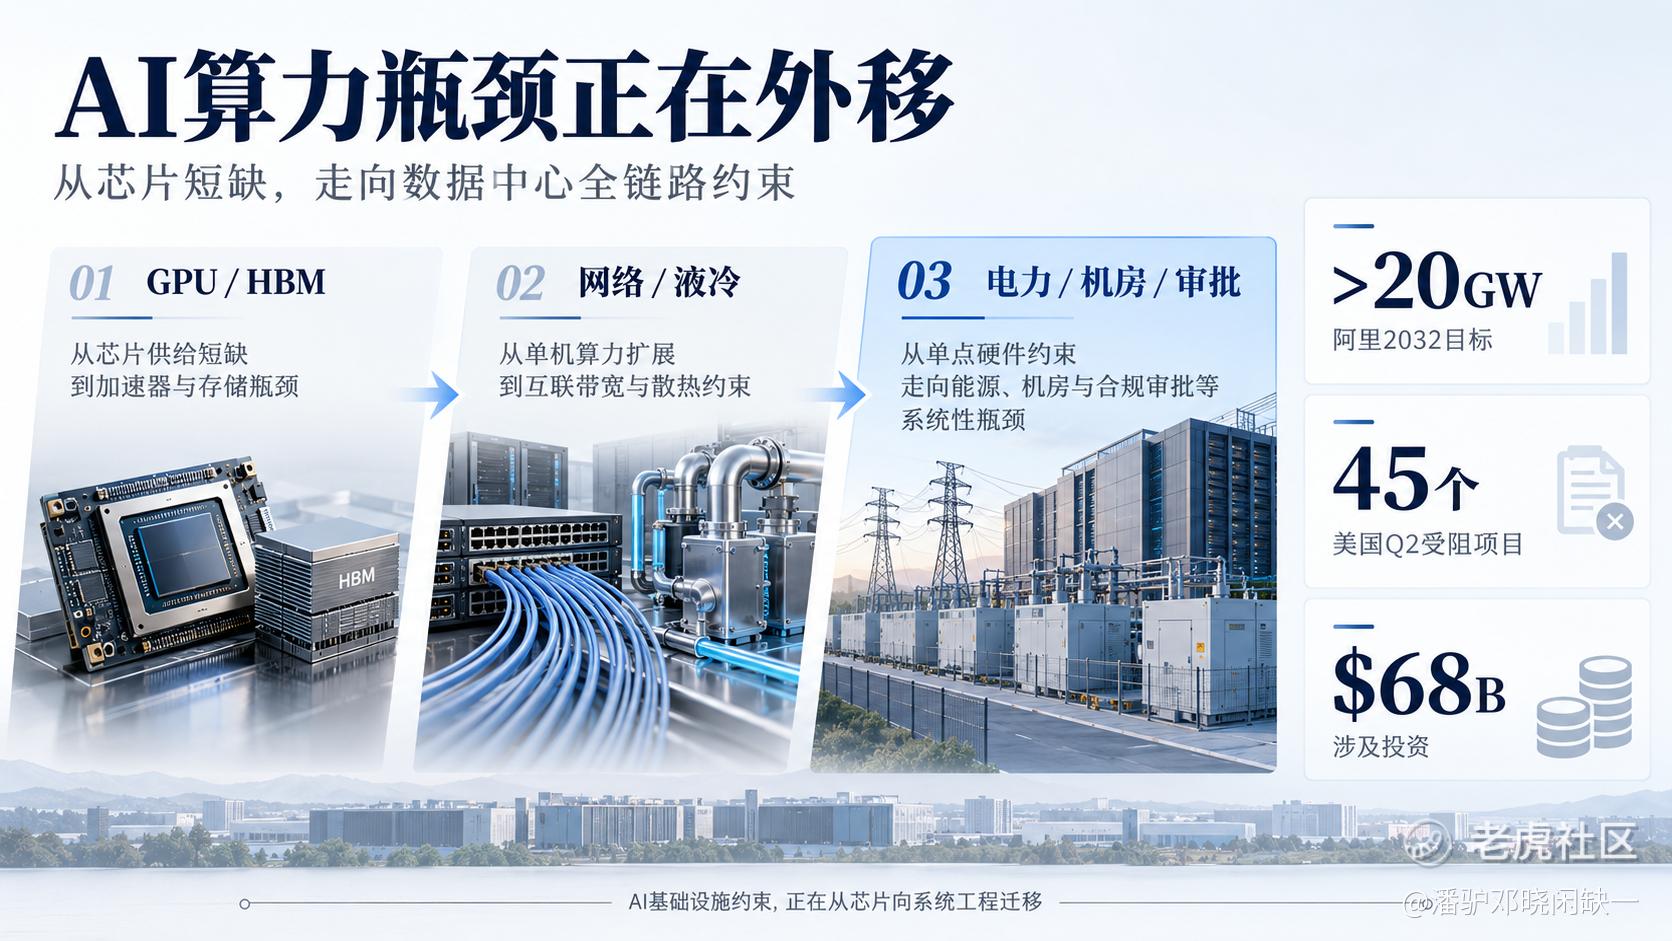
阿里在今年云栖大会给出的几个数字很有代表性:Qwen团队准备训练5万亿—10万亿参数的新模型,真武V900单集群最高可扩展到50万卡,而到2032年,阿里云运营的全球数据中心容量计划超过20GW。阿里同时提到,AI数据中心供应链的全球性紧缺,已经开始限制算力基础设施的扩张速度。
20GW以后,先解决电
20GW放在数据中心里,是个很重的数字。
GPU可以买,服务器可以加,但20GW最终需要落在真实世界里。机房在哪里,电从哪里来,配电和冷却能不能同步建好,开始直接影响算力什么时候上线。
所以阿里的20GW目标,比单纯增加一轮AI服务器采购更值得看。它把资本开支从芯片继续往外推:以前市场最关心“有多少张卡”,现在还得问一句,这些卡最后有没有地方装、有没有足够的电让它们跑起来。
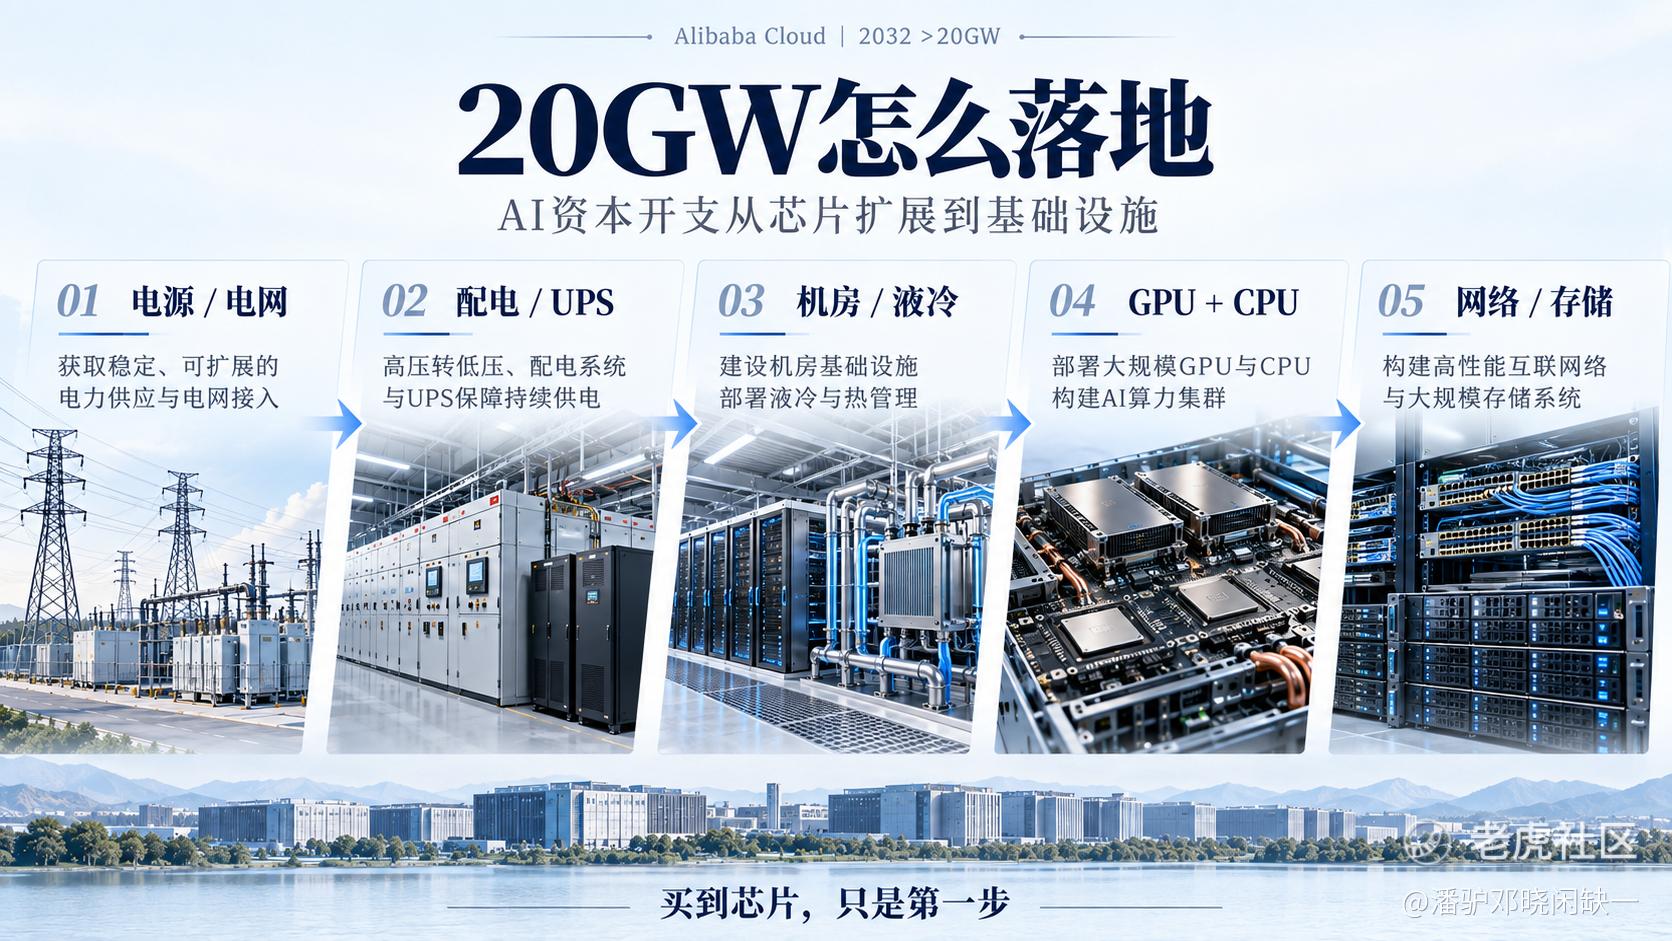
美国的数据中心建设已经开始碰到这种物理约束。
Data Center Watch统计,2026年二季度至少有45个、总投资约680亿美元的数据中心项目因为当地反对遭到阻断或延期。一季度则是75个、约1300亿美元。争议已经从早期的选址,逐渐延伸到电力、水资源、基础设施成本和审批。
电力尤其麻烦。
IEA最新基准预测里,全球数据中心用电量将从2025年的约485TWh升到2030年的约950TWh,接近翻倍;其中AI专用数据中心耗电量同期大约增长三倍。
Oracle把电力问题写进了项目进度
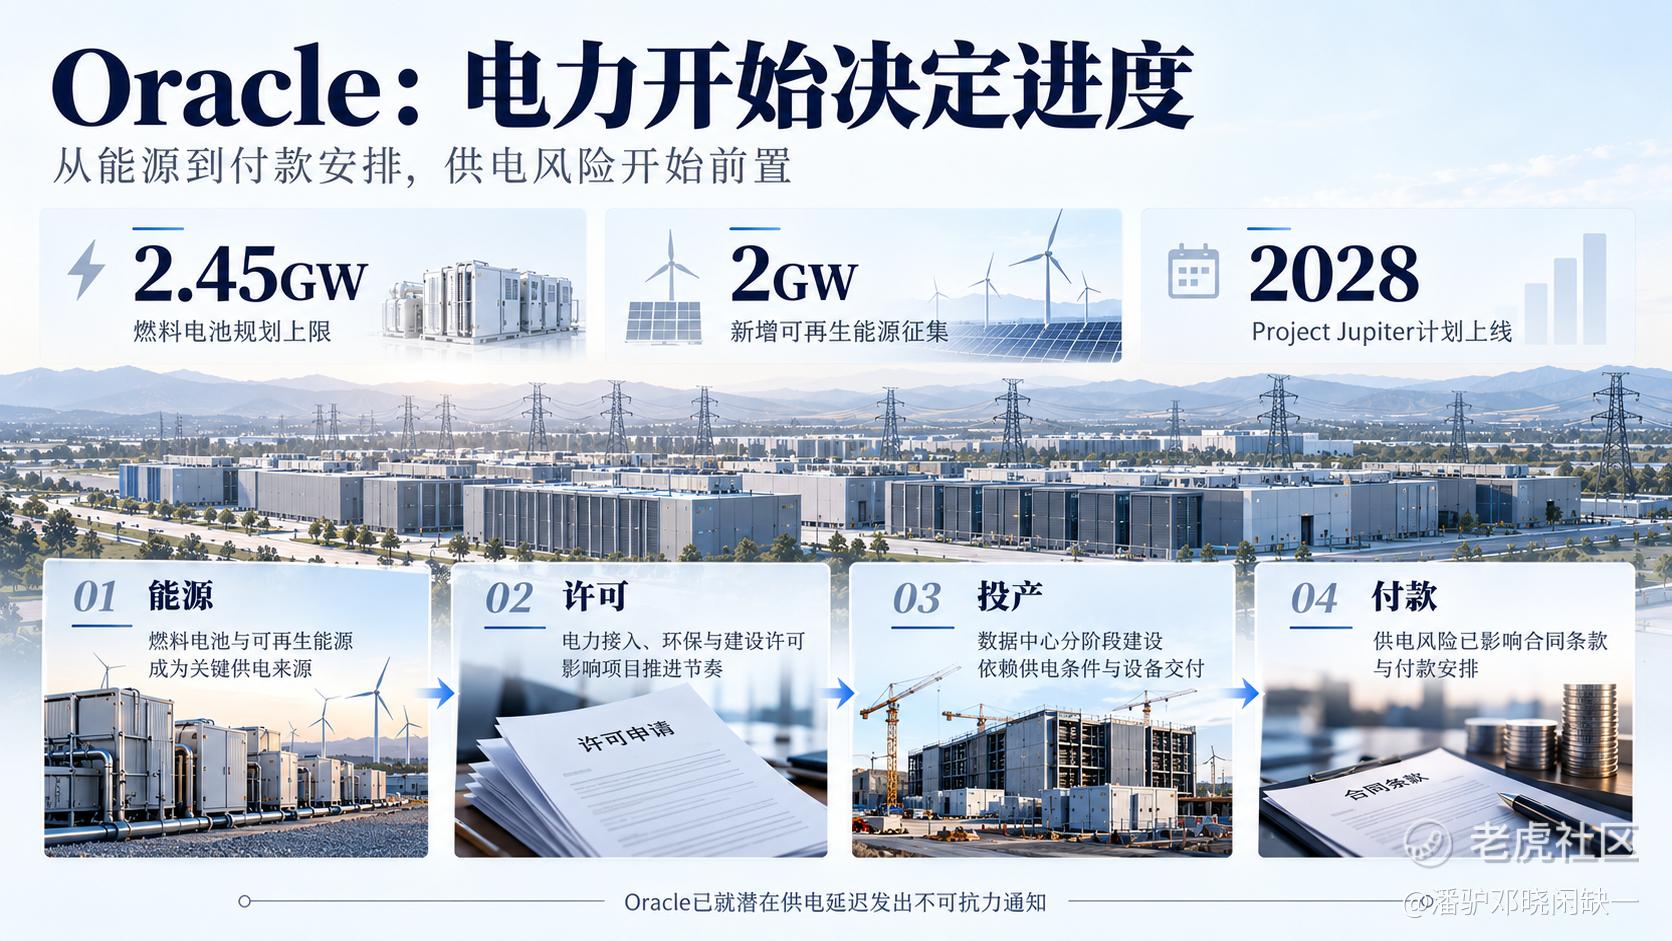
Oracle的新墨西哥Project Jupiter把这个问题摆得更直白。
项目计划部署最高2.45GW的Bloom Energy燃料电池容量;9月,Oracle又在新墨西哥州征集2GW新增可再生能源项目,希望在2027—2031年间交付。前者解决数据中心现场大规模稳定供电,后者服务于更长期的无碳能源匹配。
与此同时,Oracle已经向项目开发方发出“不可抗力”通知,理由涉及供电可能出现延迟。公司仍表示项目按照原计划推进,但如果站点无法在2028年如期上线,希望可以延后相关付款。
当供电风险开始进入租约、付款和投产节点,电力就已经从运营成本变成了项目交付条件。
变压器、开关设备、UPS、母线、备用能源、液冷和机房集成这些环节,过去经常被放在GPU之后讨论。GW级园区越来越多以后,它们更像是一组前置条件:任何一个环节慢下来,已经买到手的算力也很难按计划形成收入。
CPU也开始拿到AI的大单
GPU之外,还有一条近期很容易被忽略的线——CPU。
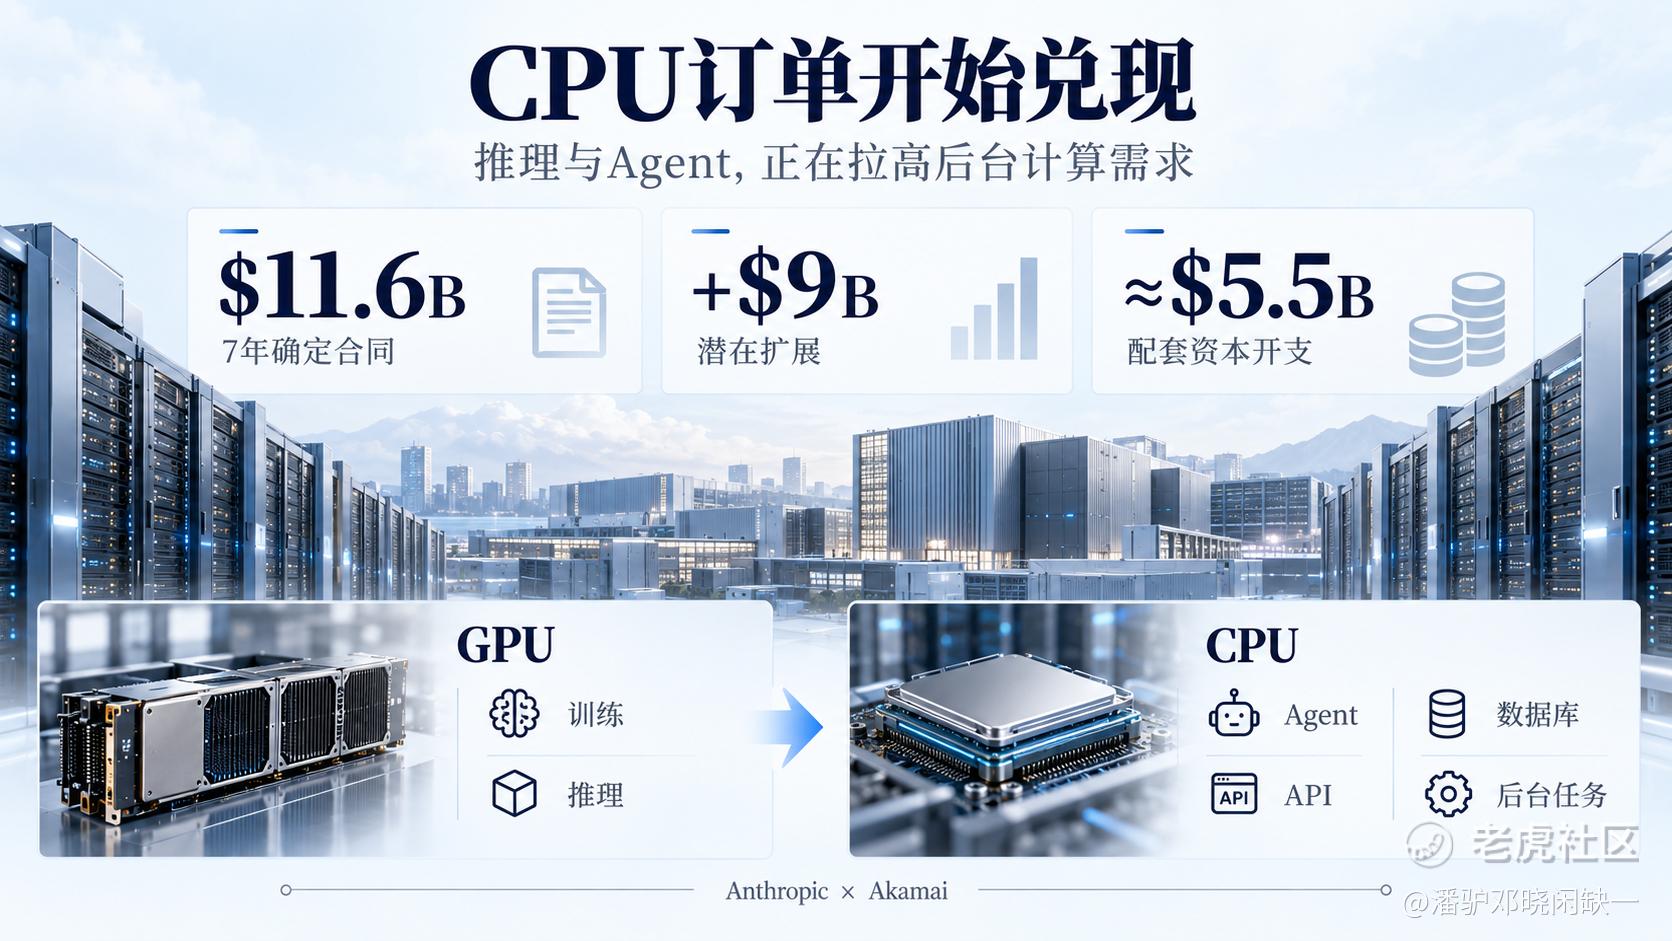
9月24日,Akamai公布与Anthropic签署116亿美元、七年期的云基础设施合同,并保留最高90亿美元的扩展空间,潜在总承诺接近200亿美元。官方对用途写得很直接:支持Anthropic快速增长的CPU工作负载。
Akamai为现有116亿美元合同预计要投入约55亿美元资本开支。其中2026年四季度约17亿美元、2027年约31亿美元、2028年约7亿美元;到2028年底达到完整收入运行水平,此后合同剩余期限预计对应约17亿美元年收入。
这组数字把“AI也需要CPU”从架构讨论变成了实际订单。
训练阶段,大规模矩阵计算把大部分注意力都吸到了GPU上。但AI开始跑更多推理、工具调用和Agent任务以后,计算结构会变得碎得多。浏览器执行、数据库访问、API调用、虚拟机、任务编排、身份验证和后台进程,都没有必要塞进价格昂贵的GPU。
这里不是从GPU切到CPU。GPU仍然承担模型训练和高密度推理,CPU则处理越来越多通用计算和系统调度。AI总计算量扩大以后,GPU继续增长,同时把CPU、内存、网络和存储一起往上拉。
智能代理把这种变化又往前推了一步。
Agent和传统聊天机器人的资源使用方式不太一样。一次问答结束,计算可以很快释放;一个持续运行的Agent却可能一直挂着浏览器、访问数据库、调用API、等待事件,再继续执行下一步任务。
运行时间被拉长以后,AI基础设施消耗的就不再是一张孤立的加速卡。
这也是为什么现在再看AI资本开支,只追下一代GPU参数已经不够了。
20GW最终拼的还是一整套东西:芯片提供算力密度,电力决定算力能不能上线,CPU和网络决定越来越长的AI任务怎么跑起来。
精彩评论