“重金招人、重组团队,字节Seed的AI野心能实现吗? ”
作者丨李娜
编辑丨岑峰
近日,29岁的曾妍成为字节跳动最受关注的年轻AI研究员之一。
据爆料,她已升至字节原职级体系中的4-2,相当于高级总监或资深技术专家级别,相关岗位的年薪酬包据估计可达数百万元。
据我们了解到的消息,在加入字节之前,曾妍曾在国内某互联网大厂实习,随后前往加拿大蒙特利尔大学攻读硕士,师从自然语言处理领域的资深学者聂建云,研究预训练语言模型与对话系统。
一位熟悉她早年经历的人士向雷峰网回忆,她对技术近乎狂热,常常戴着耳机埋头写代码,性格“大大咧咧”,很好相处。在这位人士看来,曾妍后来能够在AI领域做出成绩,除了学术研究能力,或也与她实习期较早接触工业界、积累工程实践经验有关。
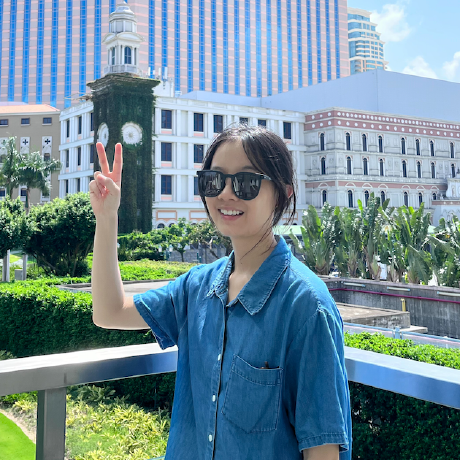
(网传曾妍本人照片)
五年前,曾妍以校招生身份加入字节跳动的人工智能研究部门AI Lab。五年后,她已经成为字节视频生成模型Seedance的重要负责人。
曾妍并不是字节近年来唯一受到关注的AI研究员。
2023年以来,字节不断招募国内外研究人员,组建独立的基础模型团队Seed。目前这支团队约1000人,研究范围覆盖语言、视觉、语音、Agent、机器人和AI for Science等多个方向。 这支队伍里,既有来自Google、阿里等科技公司的资深研究人员,也有从高校和创业公司加入的年轻研究者。字节为他们提供优厚的薪酬、单独的股权激励和相对宽松的研究条件,希望在基础模型竞争中占据一席之地。
从AI Lab到Seed,字节用了近十年时间聚集起一批来自不同背景的研究人员。曾妍是其中最受关注的年轻面孔之一,而在她身边,还有更多研究者参与着字节这场追赶全球AI前沿的长期投入。
01
字节重金招来的研究员们
在字节,一些员工把Seed团队的人称作“Seed爷”。这个称呼带着几分调侃,也有些羡慕。在大模型行业,能够参与主力模型预训练的团队,本就是不少研究人员向往的去处。Seed不仅掌握着字节基础模型研发的核心资源,还拥有更有竞争力的薪酬待遇、单独的股权激励,以及相对宽松的研究考核机制。
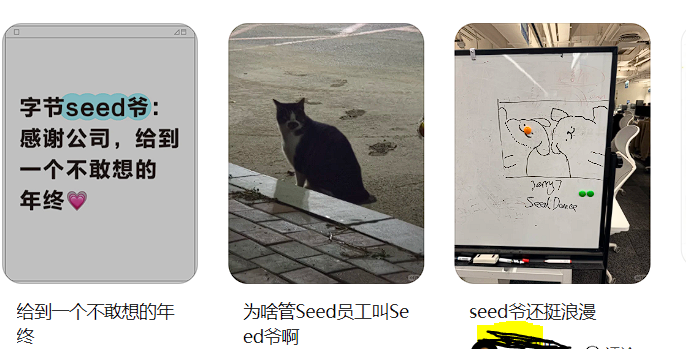
(小红书上对“Seed爷”的讨论)
字节的AI战略最早可追溯至2016年字节成立了AI Lab,那时字节最成功的AI应用仍然是依靠推荐算法的今日头条、抖音等产品,AI相关研究人员的不少工作也围绕这些已有业务展开。据《晚点》报道,2023年以前,字节AI Lab的自然语言处理团队约有100人,其中只有约10人的小团队研究大语言模型,其余人员主要从事翻译和产品优化。
不过,AI Lab也有自己的前沿研究,曾妍就是其中一位年轻研究员。
2021年,曾妍以校招生身份进入字节AI Lab,与张欣松、李航合作研究视觉语言模型。他们发表的X-VLM论文,尝试让AI更好地理解图片与文字之间的关系,比如识别一句话描述的是整张图片,还是其中的某个物体。
到了2024年,曾妍已经将研究方向转向视频生成。她以第一作者身份发表的PixelDance论文,研究如何让AI根据文字和首尾画面,生成动作更加丰富的视频。这项研究后来成为字节早期视频生成技术积累的一部分。
在此期间,字节开始重新组建自己的大模型团队。
2023年字节成立独立的基础模型研究部门Seed,最初由字节内部成长起来的技术管理者朱文佳负责,他此前长期参与推荐算法和互联网产品研发。与原来的AI Lab不同,Seed专门负责基础模型研究,字节还成立了Flow团队,负责豆包等AI应用的研发。
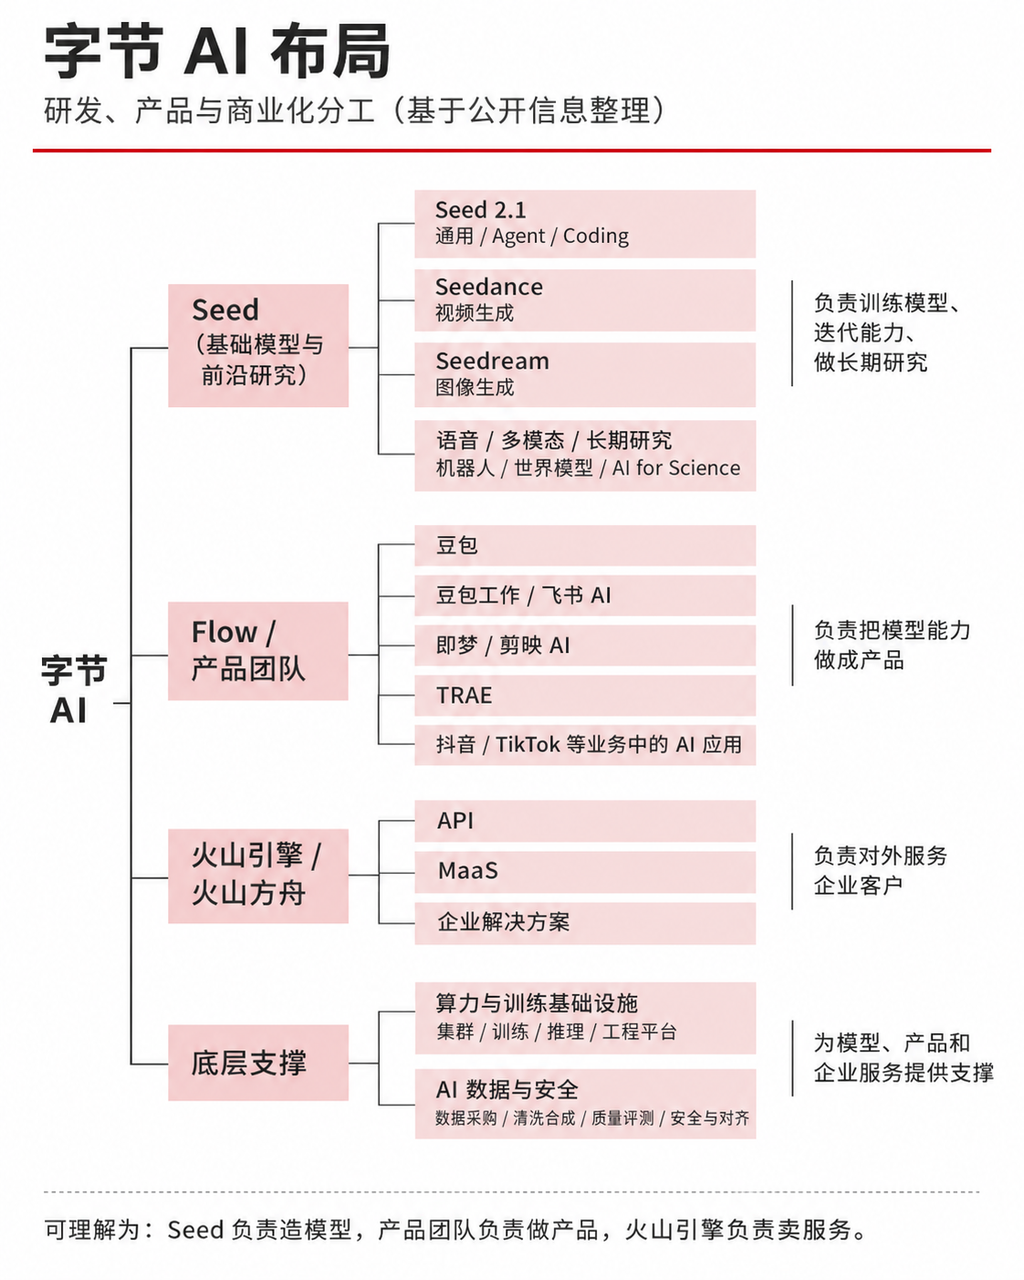
随后,字节开始从全球招募研究人员。张一鸣也亲自参与人才招聘,据《晚点》报道,从2023年第四季度开始,他频繁约见AI研究者,其中包括一些尚未毕业的博士生。2024年,字节推出Top Seed人才计划,为部分优秀应届博士提供百万级甚至更高的年薪。
这段时间,字节陆续引进了一批来自国内外科技公司的研究人员,包括曾在Google从事视频生成研究的蒋路,以及阿里通义的核心研究人员周畅。
蒋路此前是Google VideoPoet项目的重要研究人员,2024年加入字节后,参与Seaweed视频模型的研发。而曾妍所在的AI Lab也在推进PixelDance,两支团队都在研究视频生成,但最初采用了不同的技术方案。后来,随着视频生成研究逐渐整合,曾妍进入Seed,蒋路则在2025年离开字节,加入Apple。
周畅的经历有所不同。他2017年从北京大学获得博士学位后加入阿里,先后参与M6多模态预训练模型和通义相关研究,并成为通义千问的重要技术负责人之一。2024年周畅加入字节后,最初负责多模态交互和世界模型等方向,后来又陆续接管Seedream图像生成、Seedance视频生成等研究也陆续进入他的管理范围。
除了从外部引进成熟研究人员,字节也在培养年轻的模型负责人。2024年7月,曾参与面壁智能相关研究的秦禹嘉通过Top Seed计划加入字节,参与UI-TARS等Agent项目。到了2026年8月,他开始负责Seed面向办公和Agent任务的后训练部门。
2025年初,字节又迎来了一位重要人物:吴永辉。
吴永辉2008年博士毕业后加入Google,在那里工作了近17年,先后参与搜索排名、神经机器翻译和大模型研究。2023年,他成为Google DeepMind研究副总裁,参与Gemini系列大模型研发。
加入字节后,吴永辉接手Seed的基础模型研究团队。原AI Lab保留的AI for Science、机器人和负责任AI等研究方向,也在这一时期陆续并入Seed,李航转向吴永辉汇报。
据我们了解到的信息,Seed的整体规模约1000人。从李航、朱文佳等在字节工作多年的研究者和技术管理者,到吴永辉、周畅等从其他科技公司加入的资深研究人员,再到曾妍、秦禹嘉这样的年轻人,Seed逐渐汇集了不同年龄、不同研究背景的AI人才。过去十年,字节的AI研究团队也从服务内容推荐、翻译和产品优化,逐渐转向基础语言模型、视频生成、Agent等更广泛的技术领域。如今,这批研究人员参与研发的模型,已经进入豆包、即梦、剪映等产品,也有不少项目仍处于前沿研究阶段。
02
Seed究竟在研究什么?
字节花费大量资源组建Seed,并不只是为了做出一个更聪明的豆包。
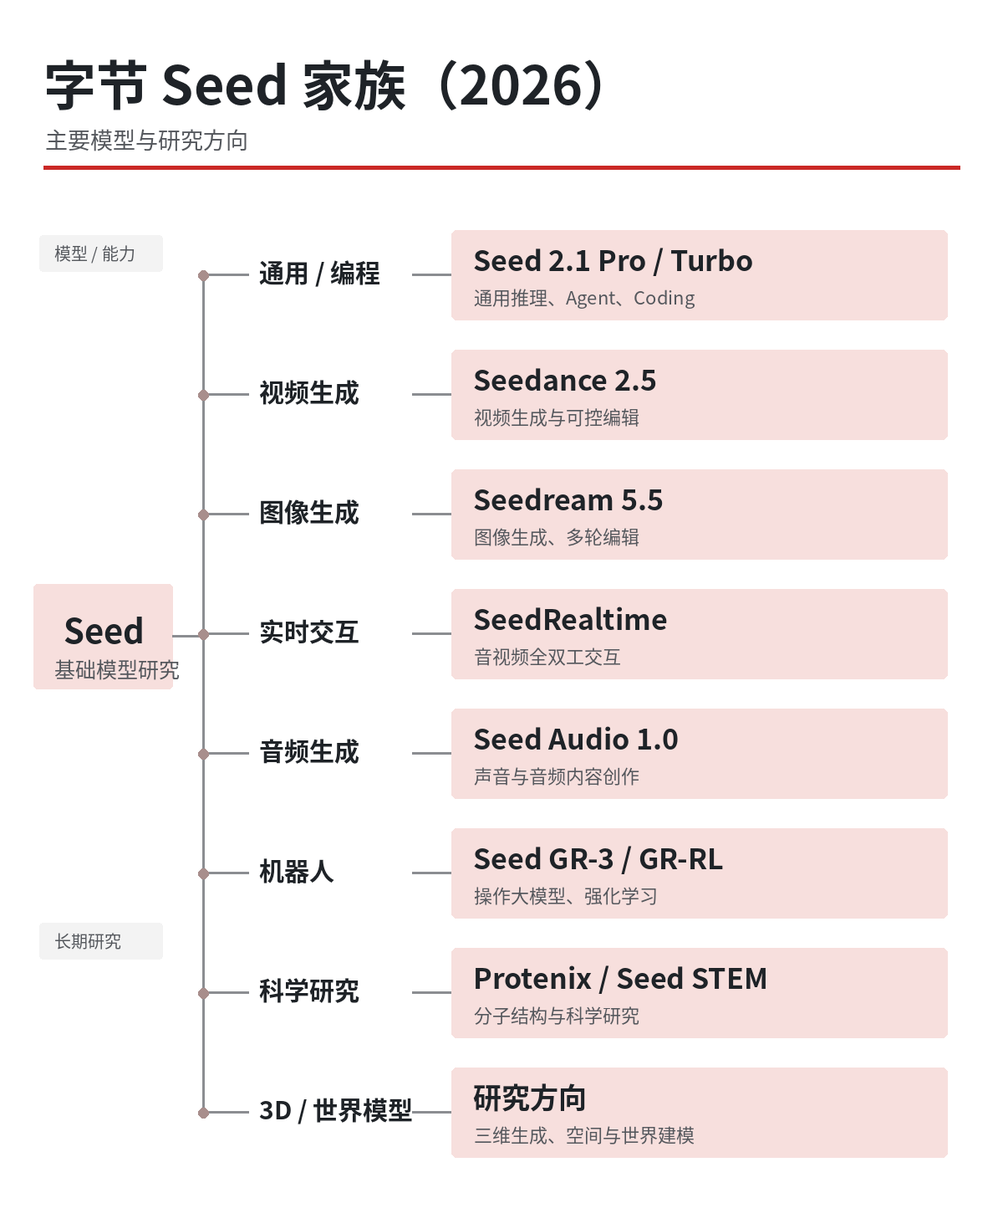
从2023年成立至今,Seed的研究范围已经覆盖语言、图像、视频、语音、Agent、机器人和AI for Science等多个领域。打开Seed的官方网站,可以看到一系列名字相近的模型:Seed、Seedance、Seedream,以及面向机器人和科学研究的技术成果。
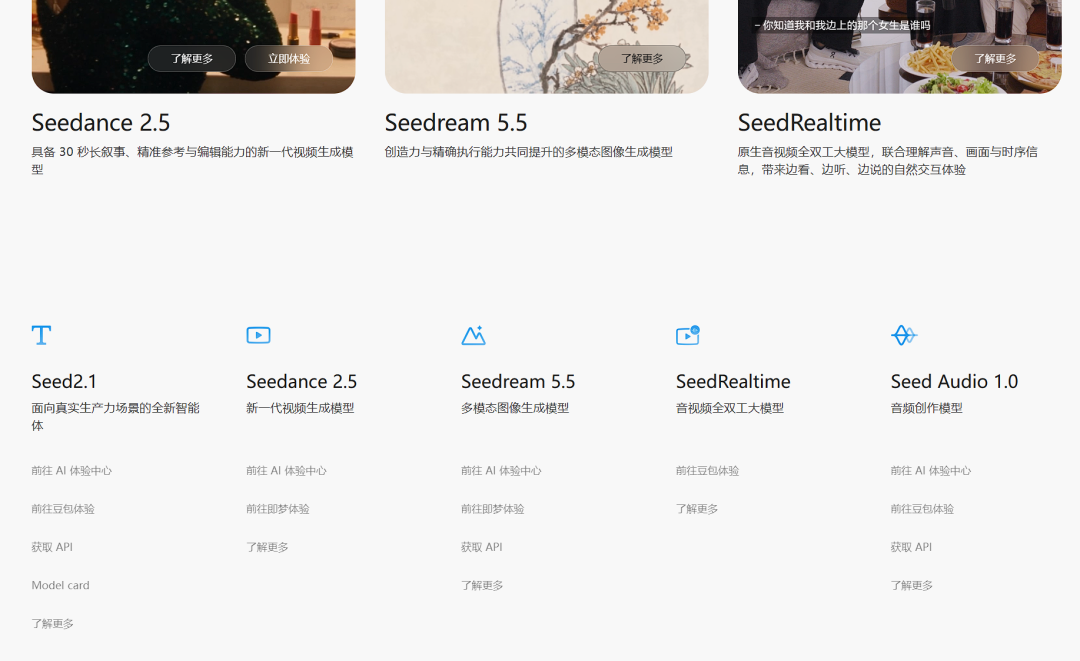
其中,基础语言模型仍然是字节投入的重要方向。它是豆包背后的“大脑”,需要完成推理、编程、内容写作等任务。2026年,字节先后推出Seed2.0和Seed2.1,持续提升模型在编程、Agent和复杂任务上的能力,并通过豆包、TRAE和火山引擎等产品提供给用户。
除了让模型回答问题,Seed也在研究如何让AI直接完成工作。秦禹嘉参与的UI-TARS就是其中一个项目,它尝试让AI理解电脑屏幕上的按钮、菜单和输入框,像人一样点击、输入、操作软件。过去,用户可以向聊天机器人询问如何完成一项任务,而这类Agent模型希望把实际操作过程也交给AI。
相比之下,Seed在视频生成领域已经取得了更加突出的成绩。
2025年6月,字节推出Seedance 1.0,随后又发布了能够联合生成声音和画面的1.5 Pro。经过多轮迭代,Seedance在人物动作、画面一致性和镜头控制等方面逐渐改善。
到了2025年底,团队准备训练下一代视频模型时,曾妍还曾因为训练规模与团队产生分歧。据36氪报道,在一次模型团队的聚餐上,曾妍向负责人提出,希望尝试训练至少2000亿参数的视频模型。但团队内部有人担心训练成本和失败风险过高,认为先训练1000亿参数级别的模型更加稳妥。后来,在Seed内部的正式评审中,吴永辉和视觉多模态生成方向负责人周畅支持了她提出的更大规模训练方案。
2026年2月,Seedance 2.0正式发布,引发外界广泛关注。尽管这款模型风头很盛,视频生成仍只是Seed研究版图的一部分。
与Seedance相对应的是图像生成模型Seedream,主要用于海报制作、图片修改、设计素材生成等任务,已经进入即梦等内容创作产品。在语音领域,Seed则研究如何让AI听懂人说话、生成更自然的声音,甚至在交谈过程中同时理解声音和画面。这些能力可以用于豆包的语音交互,也可以服务实时翻译、智能助手等场景。
除了这些已经进入消费产品的技术,Seed还有一批面向真实世界和科学研究的项目。
例如,Seed GR系列机器人模型尝试让机器人理解周围环境,根据指令完成抓取、移动等动作。与聊天或视频生成不同,机器人不仅要理解任务,还要在真实环境中完成操作,因此需要解决空间感知、动作控制等问题。
AI for Science则尝试将大模型用于生物、化学等科学问题。字节此前推出的SeedFold、SeedProteo等研究,涉及蛋白质结构预测和设计,希望借助AI提高科学研究的效率。与视频生成相比,这些研究距离大规模商业应用还有更长的路要走,也需要通过实验验证模型的实际效果。
此外,Seed还有一部分研究人员负责模型训练系统、数据处理和推理效率。这些技术不会直接变成一款用户能够下载的产品,却关系到模型能否稳定训练、能够扩大到什么规模,以及最终运行需要多少成本。
03
1000人的研究团队如何工作?
2025年初,吴永辉从Google加入字节时,Seed已经汇集了一批来自不同公司和高校的研究人员。当时,Seed主要由吴永辉和朱文佳两位负责人分工管理:前者负责基础模型研发,后者负责模型应用。朱文佳是字节的老员工,2015年加入公司,曾担任今日头条CEO,也是2023年字节组建大模型团队时的重要负责人。
吴永辉加入后,开始着手了解这支研究队伍。据《晚点》报道,他曾与100多名核心研究员逐一交流,发现Seed虽然拥有许多优秀人才,不同小组之间的协作却并不顺畅。与此同时,Seed的管理关系也在调整。2025年10月,朱文佳改为向吴永辉汇报,吴永辉进一步统筹基础模型与多模态研发。
这种情况与字节此前的研发方式有关。不同团队可以同时尝试不同的技术路线,再根据研究结果决定后续投入。对于仍在探索中的AI技术,这种方式能够保留更多可能性,但随着Seed规模扩大,团队之间的研究也越来越难以完全分开。尤其是训练一个大型基础模型,涉及的数据、算法和基础设施往往来自不同团队,任何一处出现问题,都可能影响整个训练过程。
吴永辉开始推动调整。2025年,Seed将研究工作划分为Edge、Focus和Base三个层次,分别面向长期前沿探索、下一代模型研发,以及当前模型的训练和交付。同时,他推动内部数据、代码共享,让研究人员更频繁地交流进展。据《晚点》报道,过去部分团队三个月才召开一次会议,后来改为每月汇报,一些核心团队则基本每两周沟通一次。
不过,组织调整并不能立即解决所有问题。2025年下半年,字节在训练新一代豆包模型时遇到了稳定性问题。据《晚点》报道,随着模型规模扩大,训练一度难以继续推进,多个团队花费约三个月,从模型架构、训练数据等方面进行调整,才让豆包2.0赶在2026年春节前上线。今年6月离开字节的顾全全在《晚点聊》访谈中也提到,一些技术方案几个月前就已经提出,团队经过长时间讨论和验证后,最终还是选择了最初的方案。当技术方向逐渐明确、竞争转向执行效率时,组织本身就成了模型能力的一部分。
到了2026年8月,Seed又进行了一轮组织调整。这一次,变化涉及具体研究部门的分工。原本分散在文本、代码、视觉理解和语音等方向的预训练数据团队,被整合进统一的Pretrain Data部门,部分强化学习研究人员被集中到Horizon RL部门。负责模型后训练的团队则进一步分为Work和Chat两个方向,分别由秦禹嘉和朱文佳负责,前者面向办公、编程和Agent等工作任务,后者侧重豆包等消费端产品需要的对话能力。
研究方向的整合,也影响了一些研究负责人的职责。据媒体报道,周畅此前负责的部分视觉语言模型研究被并入基础语言模型体系,其管理范围随之发生变化。此后,关于周畅离开字节、转向Physical AI创业的消息陆续出现,但公开报道存在不同说法,尚不能确定他的去向与这轮组织调整之间是否存在直接联系。
这几年,Seed内部的研究人员也在承担不同的角色。曾妍从AI Lab的校招生逐渐走到重要视频模型的研发岗位,秦禹嘉从Agent研究者成为Work后训练方向的负责人,而周畅等人的管理范围则随着组织调整发生变化。这些个体经历未必能概括Seed全部的人事变化,却能够看出,字节在持续招募研究人员的同时,也在不断重新安排他们负责的研究工作。
到2026年,Seed已经不再是几支相对独立的AI研究小组。字节一方面希望保留研究人员探索新方向的空间,另一方面又需要让不同团队共同完成规模越来越大的模型训练。对于这支仍在扩张和调整中的队伍来说,如何兼顾两者,已经成为招来人才之后必须面对的事情。
04
张一鸣说,还要三四年
今年7月底,张一鸣与吴永辉共同参加了一场Seed内部全员会。据《晚点》报道,张一鸣当时表示,字节可以接受基础模型暂时落后,不希望研究团队只追逐Coding等短期热点,也反对依靠竞争对手的模型输出进行蒸馏训练。
到了11月,他又给出了一个更具体的时间判断,张一鸣认为字节有能力与OpenAI、Anthropic竞争,但真正追平最前沿的技术,最早也要到2029年或2030年。
字节过去最成功的AI应用是推荐算法,它帮助今日头条、抖音等产品获得了大量用户。如今,字节希望掌握的,是能够支撑更多产品的基础模型能力。这或许也解释了为什么即使暂时落后,它仍然愿意持续投入Seed。
从曾妍这样的年轻研究员,到吴永辉等从海外科技公司加入的资深科学家,字节已经花费数年时间聚集起一批人才。但与招聘不同,基础研究的积累很难依靠资金在短时间内完成。对于习惯了互联网产品快速迭代的字节来说,这可能是一场比过去任何一次技术投入都更漫长的尝试。

▼
推荐阅读
▼
流沙之上:陈冕、景鲲、倪正民和中国 AI 应用创业者的三种选择
2026-09-01
独家解读丨字节 Seed 大调整,分支背后谁在操盘?
2026-08-21