


混元 Hy4:腾讯第一次说“跻身开源最强”
11 月 4 日,腾讯混元发布了新一代大语言模型 Hy4。
公告里有个措辞值得注意——“Hy 首次跻身最强开源模型之列”。腾讯很少这样给自己的模型定位,用词的变化通常意味着内部评测到了某个临界点。
比措辞更有信息量的,是公告里三个“首次”:
-
首次跻身最强开源模型之列
-
首次引入视觉理解能力
-
首次支持电脑操作(Computer Use)
前两个是能力补齐,第三个是形态变化。
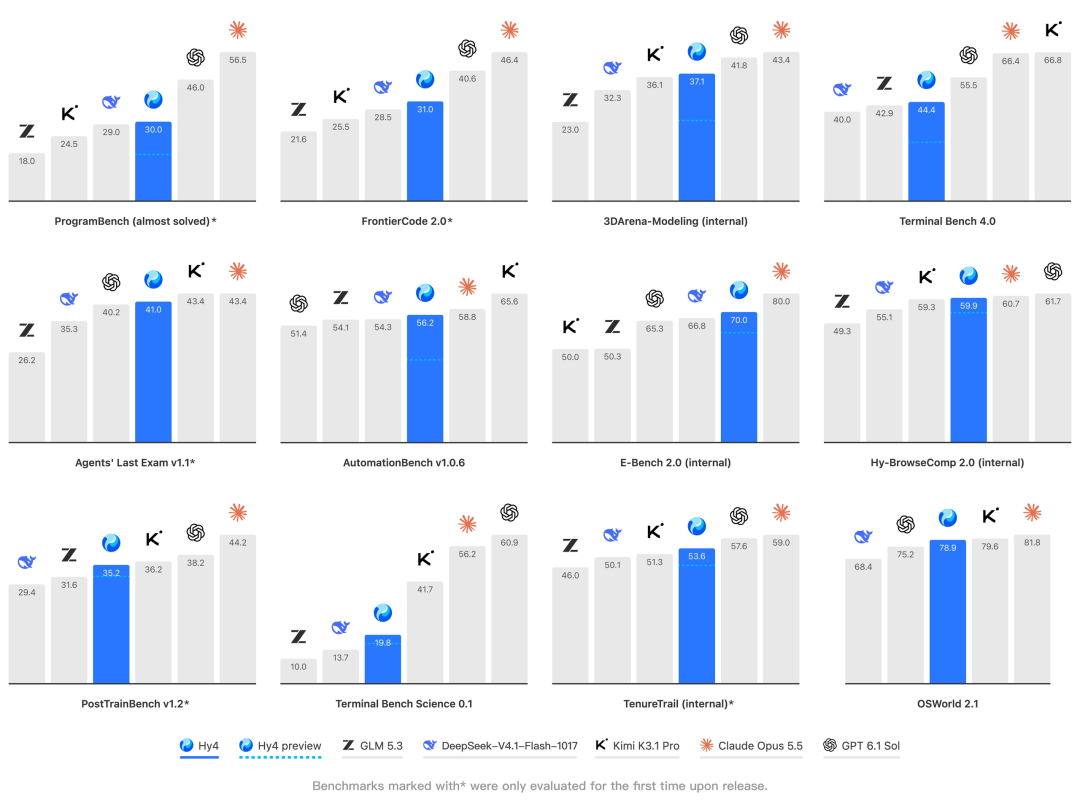
腾讯混元 Hy4 官方发布信息图
一、从 Preview 到正式版,改了什么
对比上一版 Preview,Hy4 的改进集中在三块:
① 预训练和后训练都显著扩了数据和训练规模。 这是最朴素也最有效的一步,没有花哨说法。
② 第一次具备视觉理解。 官方给的场景是细粒度图像处理、复杂图表分析、数学视觉推理。对做分析类内容的人来说,第二项“复杂图表分析”的实际价值可能比想象中大——过去这类活要么靠 OCR 硬转文本,要么人肉看。
③ 长文理解、指令遵循、长程智能体三项综合效果大幅提升。 “长程智能体”是这次真正的主线,后面四类场景都建立在这条能力上。
二、四大实用场景,实测说了什么
官方这次没有只放跑分,而是按四类真实工作场景给了具体数字。
场景一:办公 —— WorkBuddy 里的平均 83.18 分
Hy4 全面接入了腾讯自家的办公产品 WorkBuddy。评测结果是:
-
平均效果得分 83.18 分
-
通过率 96.15%
-
12 个评测场景中,9 个排名国内第一
实际体验里提到的能力是视觉创意、3D 场景构建、网页开发。另外针对 WorkBuddy“人机双写”的特性(人和模型同时编辑同一份文档),Hy4 在文档美观度、稳定性、可用性三方面做了专项优化。
还有一个细节值得注意:Hy4 可以借助企业微信套件,连通聊天记录、邮件、文档、日程与会议。多个项目并行时,它能理清各项目的推进历史和最新进展,识别待跟进任务、需要准备的会议、临近截止的事项。
这不是“问答”,是“有上下文的工作助理”。
场景二:金融 —— 213 位专家的众测
金融是这次投入最重的一块。混元基于真实金融场景构建了数千个工作空间、上万个高质量任务,覆盖基金研究、证券分析、量化策略。
评测方式也值得说:联合腾讯金融科技团队做金融专家众测,213 位专家中 153 位来自外部头部金融机构,七成有五年以上工作经验。
基于 579 个真实金融任务的结果:
| 模型 | 众测得分 |
|---|---|
| Hy4 | 3.04 |
| DeepSeek-V4.1-Flash-1017 | 2.97 |
| Kimi K3.1 Pro | 2.68 |
| GLM-5.3 | 2.68 |
在金融智能体公司讯兔科技的内部评测 IRAB 中,Hy4 比 Preview 版提升 12.03 个百分点。
同一块里还有一组更关键的数字——幻觉治理:
-
幻觉率:12.95% → 7.2%
-
猜测导致的错误率:23.1% → 5.6%
金融场景里,猜错比答不出严重得多。这组数字比跑分更能说明“能不能用”。
场景三:前端与游戏 —— GameDev 提升 19.1%
针对前端的复杂交互、业务逻辑、状态管理、前后端联动做了专项优化,目标是生成的界面“不仅美观,而且功能完整可用”。
游戏方向是与腾讯 IEG 的专业游戏开发者合作的,重点提升游戏功能实现、玩法逻辑、状态理解、资产处理,已实现 UE、Unity、Godot 三大引擎的深度适配,并开始扩展到多人联机游戏开发。
对比 Preview 版:
- GameDev 评测 +19.1%
- GameLogic 评测 +9.8%
场景四:科学研究 —— 七大学科 123 项任务
把复杂推理、科学编程与长程任务执行结合起来推科研。在内部评测 TenureTrail 中,覆盖七大学科、123 项可执行研究任务,Hy4 在数学构造、物理建模、地球环境、系统工程、社会经济决策等领域表现扎实。
三、真正值得注意的:Computer Use
四个场景都在讲能力,但形态上的变化是这一条:Hy4 第一次支持电脑操作。
它可以结合命令行和图形界面处理任务。更关键的是,混元针对 Blender、CAD 这类专业软件和跨应用长程任务做了专项训练。
这句话的分量在于:大多数模型的能力止步于“生成内容”,而操作电脑意味着“执行流程”。前者产出的是建议,后者产出的是结果。
同时这也解释了为什么它要做长程任务训练——一旦开始操作软件,任务长度就从“一轮对话”变成“几十步操作”,中间任何一步错都要能自己纠正回来。
四、冷静看三件事
第一,权重还没放出来。 公告的原话是“将于近期开源模型权重,发布模型系统卡片”。也就是说,现在能确认的是能力和评测,开源是承诺不是既成事实。想本地部署的人还得等。
第二,评测口径要看清。 办公场景的 83.18 分、12 场景 9 个国内第一,是围绕 WorkBuddy 这个产品做的;金融众测有腾讯金融科技团队参与组织;游戏评测与 IEG 合作;科研用内部 TenureTrail。这些都不是第三方独立评测,是“官方 + 合作方 + 真实任务”的组合。真实,但不完全中立。
第三,开源最强是个位次问题。 榜单会变,位次会换。真正决定这套模型能不能留在生产环境里的,是三个更朴素的问题:幻觉率够不够低、长程任务能不能收敛、专业场景里的规范懂不懂。
最后
从这次发布能看出一个清晰的转向:从“模型能力”转向“场景闭环”。
四个场景不是随便挑的——办公、金融、前端游戏、科研,全是腾讯自己有真实业务、有现成产品、有海量任务的地方。模型在这些场景里被评测,也在这些场景里被使用。
这条路比对榜更难走,因为它要求模型真的能交付结果。但也正因为如此,它的进步是可验证的——不是看分数涨了多少,而是看有多少活被真的干完了。
本报告仅供参考,不构成投资建议。投资有风险,入市需谨慎。
路过银河AI | 2026年11月4日
免责声明:上述内容仅代表发帖人个人观点,不构成本平台的任何投资建议。
