


大家还记得百度吧?把 280B 的基座模型开源了
11 月 5 日,百度开源了 ERNIE-5.5-Flash-Base(文心 5.5 Flash Base)。
数字先摆出来:总参数 280B,每 token 激活 14B,33.5T tokens 从零预训练,训练上下文 128K,微调与推理支持 1M tokens。
这在国产开源模型里是第一次有这个量级的基座被放出来。
但有一个细节必须先说清楚,否则整篇都会读歪——
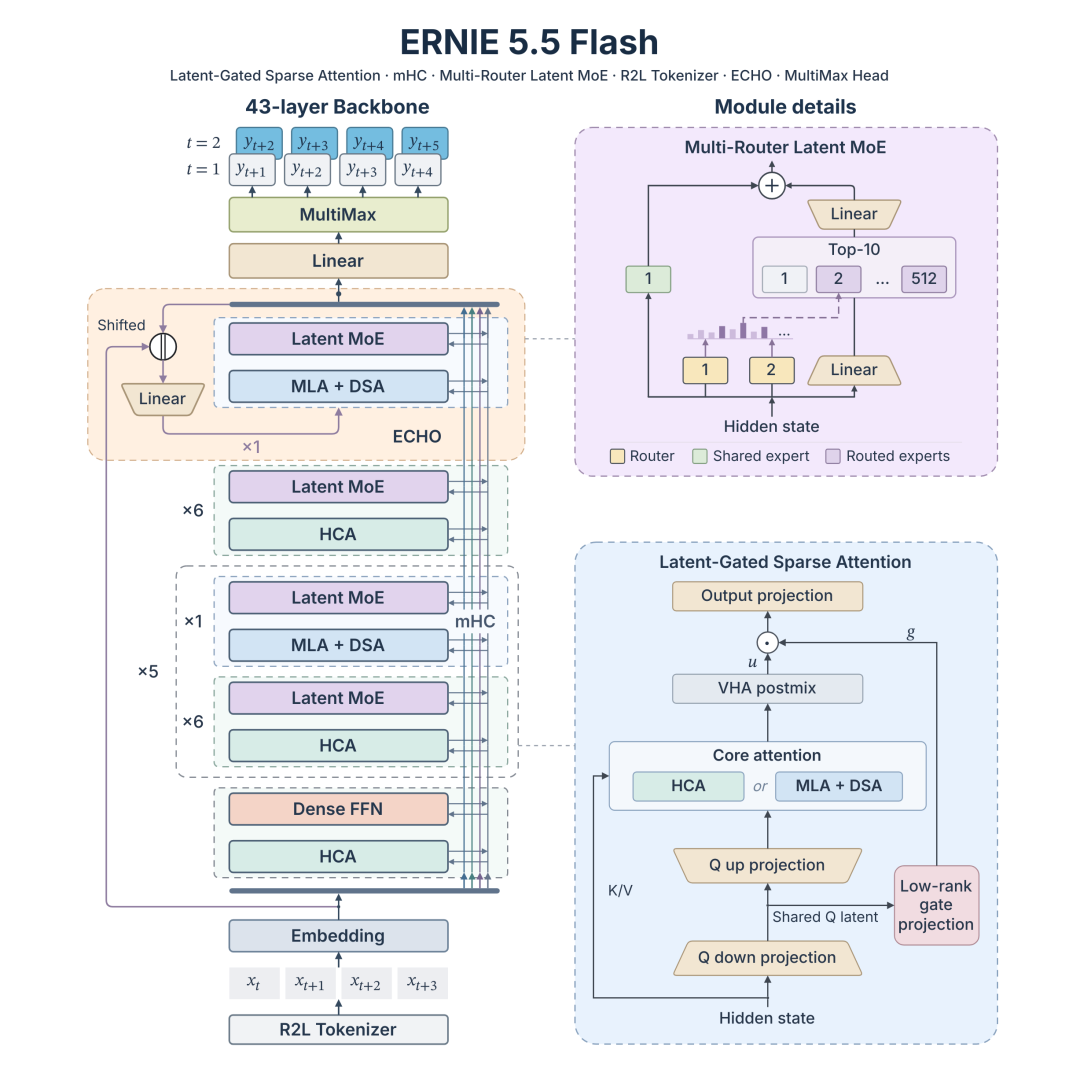
ERNIE 5.5 Flash 模型结构
一、它开源的是“起点”,不是“成品”
官方文档写得很直白:
本次发布的权重是预训练终点的 checkpoint,未经中训练与后训练,可作为领域适配、指令微调和强化学习研究的共同起点。
翻译成人话:它不会聊天。
你下载下来直接对话,大概率得到一堆不知所云的续写——因为它没做过指令微调,没学过“用户提问—助手回答”的格式,也没有经过任何偏好对齐。
那开源它干什么?
官方给的理由是:
不同的领域、推理任务和 Agent 应用,需要不同的数据、训练目标与行为策略。开放预训练终点权重,让开发者能够在已有的通用能力之上,自行选择模型下一阶段的训练方向。
这是给做后训练的人用的:你要做金融模型、医疗模型、Agent 模型、推理强化,它就是那个“已经预训练好的底座”,省掉你烧 33.5T tokens 的钱。
二、这次真正的技术看点:它为什么这么“省”
280B 的模型要能跑起来,光堆参数是不行的。ERNIE 5.5 Flash 的架构几乎每一处都在回答同一个问题:怎么在保留能力的前提下,把激活计算和 KV cache 压下去。
① 混合注意力:每七层只留一层看全上下文
大多数层其实只需要对远距离历史有粗粒度视野。所以它每 7 层里只保留 1 层做 token 级的全上下文访问(用 MLA,多头潜在注意力),其余 6 层用重度压缩注意力(HCA)——每 128 个 token 压缩成一条缓存条目,只在这些压缩条目加一小段最近 token 上做稠密注意力。
结果是:43 层里有 37 层在 128 倍压缩后的序列上算注意力,KV cache 大幅缩小。
② 头维度按层分配,不再全模型统一
-
HCA 层计算量小,用 512 维宽头
-
MLA 层逐 token 访问、计算量大,用 256 维窄头
计算量小的层给大维度,计算量大的层给小维度——这是个很朴素的成本-收益判断,但大多数模型不做这种分层设计。
③ 少数全上下文层用稀疏注意力(DSA)
只有 MLA 层要逐个访问历史 token。如果做稠密注意力,长上下文时计算量会全压在这几层。所以它们用 DSA:一个轻量 indexer 给历史位置打分,核心注意力只在得分最高的 top-k 上算——每个 query 的开销不再随上下文长度增长。
此外还有 Latent MoE、流形约束超连接、MultiMax 输出头、ECHO 分词器等组件,整体是围绕“持续训练与推理的效率”做的系统设计,而不是单纯堆规模。
三、评测:同尺寸档位的横向对比
官方把同级三个 Base 模型放在同一套框架、相同 prompt 与 few-shot 样例、同一个裁判模型下对比:
| 模型 | 总参数 | 激活参数 |
|---|---|---|
| ERNIE 5.5 Flash Base | 280B | 14B |
| DeepSeek V4 Flash Base | 284B | 13B |
| Hy3 preview Base | 295B | 21B |
| MiMo V2.5 Base | 310B | 15B |
几个关键分数(ERNIE 5.5 Flash Base):
| 维度 | 项目 | 分数 |
|---|---|---|
| 综合 | MMLU | 93.3 |
| 综合 | MMLU-Pro | 78.4 |
| 知识 | SimpleQA | 34.1 |
| 理科 | GPQA | 60.2 |
| 推理 | BBH(CoT) | 89.2 |
| 代码 | HumanEval+ | 82.3 |
| 代码 | LiveCodeBench | 40.1 |
| 代码 | RepoQA | 91.7 |
| 长上下文 | LongBench-v2 | 48.7 |
| 长上下文 | HELMET-ICL | 85.9 |
对照之下,HumanEval+ 这一项:ERNIE 82.3 vs DeepSeek 69.5、Hy3 78.0、MiMo 74.4。代码能力是这代最突出的一块,官方也明说数据侧重点加强了“仓库级代码与长上下文理解”。
需要客观看待的两点:MMLU-Pro 上有明显领先(78.4 vs 69.2/66.9/65.7),但长上下文里 HELMET-Rerank、InfiniteBench 两项并不占优,分别落后于 DeepSeek 和 MiMo。不是全面碾压。
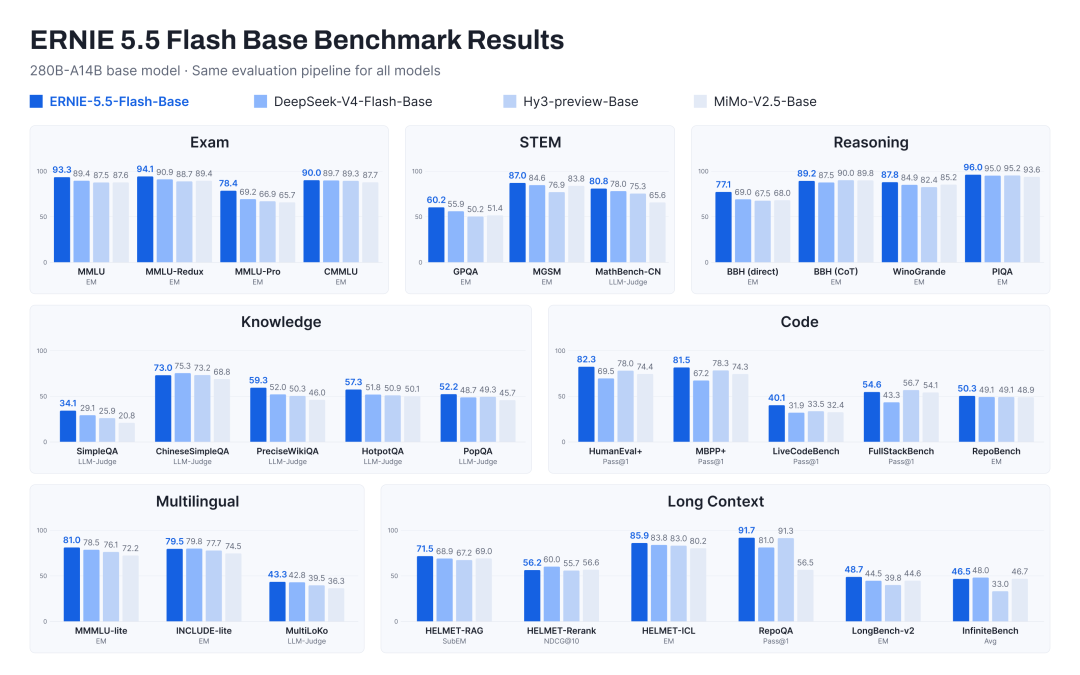
ERNIE 5.5 Flash Base 总体评测结果
四、开源方式与许可
- 权重
:Hugging Face 上提供 FP8 与 BF16 两种 safetensors(BF16 版本名为 baidu/ERNIE-5.5-Flash-Base-BF16)
- 许可
:ERNIE 5.5 Flash Base Model License Agreement v1.0
- 用法
:Base 模型要求每条输入以 BOS token 开头,分词时保持 add_special_tokens=True
五、三件需要冷静看的事
第一,它不能直接当产品用。 这是 Base checkpoint,不是 Chat 模型。想用它得自己准备后训练数据、训练目标和对齐流程——这活不轻,是把 33.5T tokens 的成果变成“你的模型”的必经一步。
第二,许可是“自定义协议”不是 Apache/MIT。 用之前务必读一遍条款,尤其是商用、再分发、以及基于它训练出的衍生模型怎么处理。这类协议通常比标准开源许可严格。
第三,1M 上下文是“支持”不是“效果好”。 训练时是 128K,1M 是微调和推理侧的支持能力。超过训练长度后效果如何,取决于你后续怎么训练它——这正是 Base 模型的特点:能力边界的很大一部分,交给下游决定。
六、这件事真正的意义
过去两年,国产开源模型的竞争主要发生在“成品”层面:谁的 Chat 模型更好用、谁在榜上分更高。
这次百度放出来的是另一个东西——一个未经后处理的高质量起点。
它的价值不在于“直接能用”,而在于三件事:
1. 省下预训练成本:280B / 33.5T tokens 的训练是绝大多数团队做不起的;
2. 提供可对照的研究基线:官方强调这是“阶段明确的研究基线”,不同训练方法在同一 checkpoint 上做对照才有意义;
3. 把效率设计公开:MLA+HCA 混合注意力这套方案,对做长上下文推理的人有直接参考价值。
用一句官方的话收尾:
开放预训练终点权重,让开发者能够在已有的通用能力之上,自行选择模型下一阶段的训练方向。
开源争到这个层面,比的已经不再是谁的模型更会聊天,而是谁能把训练投入的成果变成别人做研究的起点。
本报告仅供参考,不构成投资建议。投资有风险,入市需谨慎。
路过银河AI | 2026年11月5日
免责声明:上述内容仅代表发帖人个人观点,不构成本平台的任何投资建议。
