


拿下京东的十万卡集群订单,摩尔线程Q3实现盈利?
2026年9月9日,京东全球科技探索者大会上,京东云宣布拟采购摩尔线程十万卡GPU集群,预计2027年建成,服务零售、物流、仓储等核心业务。
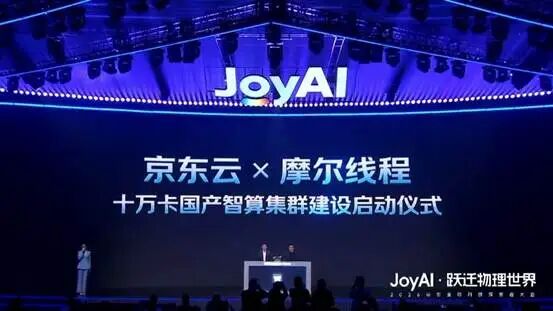
消息出来,国产芯片正式从大厂的备选方案变成了主力选项,成为芯片行业讨论最热烈的话题。十万卡级,意味着进入核心生产系统,承担真实的大规模AI负载。这在两年前几乎不可想象。
行业格局正在以远超预期的速度改写。
行业数据说明了一切
先把视线拉回整个国产算力赛道。
TrendForce最新预测显示,2026年中国高端AI芯片市场中,国产解决方案份额将接近90%。2025年这个数字大约是41%。一年时间,翻倍式跃升。留给英伟达的空间从绝对主导快速压缩到可能只剩一成。
支撑这一变化的是互联网大厂的真实采购行为。腾讯2026年二季度资本开支达527.84亿元,同比增长176%。国内CSP巨头的算力缺口摆在那里,英伟达受限之后,这些需求只能由国产芯片承接。
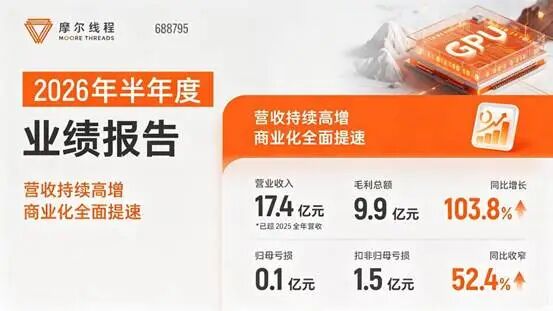
半年度财报给出了更直接的证据。2026年上半年,摩尔线程营收17.36亿元,同比增长147.42%,已超过2025年全年。云端产品收入16.93亿元,占总收入的97.5%——这是实打实地在AI训练和推理主战场拿到份额。
京东为什么选了摩尔线程
很多人以为这笔订单是“支持国产”,但商业逻辑从来不是这么简单。
京东2026年AI专项研发投入同比增长超过200%。京东拥有中国最复杂的零售、物流和仓储体系,具身智能是仓库里每天正在发生的现实需求。
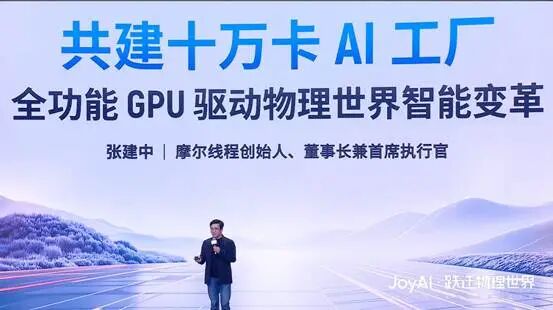
物理AI对算力的要求很特殊。训练机器人策略模型需要AI计算,模拟物理环境需要物理仿真,生成训练数据需要图形渲染。三件事要一起做。传统架构下需要三种不同的芯片、三个平台,数据来回搬运,效率极低。摩尔线程的全功能GPU在一颗芯片上同时完成这三件事。
京东云总裁曹鹏在WAIC演讲中的表态已经很明确:JoyAI部分训练算力跑在MTT S5000上。这笔合作的深度远超简单的“买卡”。
交付能力是真正的分水岭
十万卡订单能不能跑起来,靠的是真本事。
摩尔线程的夸娥万卡集群已经在北京、无锡、杭州等多地完成部署交付。线性扩展效率95%,有效训练时长超90%,训练精度与国际主流计算卡持平。万卡集群的难度从来不是把一万张卡连在一起,而是让它们在大规模并行训练中不掉线、不降速。能做到这三条的国产GPU厂商,目前只有摩尔线程和**。
更硬核的证据在大模型训练上。夸娥集群完成了MoE-236B基础模型的从零训练、北大EvoPhys全球首个5D世界模型的原生训练、智源具身大脑RoboBrain 2.5的全流程训练。如果说单卡跑推理是开卷考试,从零训练大模型就是闭卷写论文。
半年报里一个6.6亿元的夸娥合同上半年已完成交付确认收入。账面上35.50亿元的存货、13.44亿元的预付款,映射的是为保障供应链的战略备货。寒武纪的存货结构是同样的逻辑:82.48亿元存货中,原材料57.49亿元、库存商品仅0.85亿元——芯片造出来就卖掉了,根本不愁需求。
值得关注的是,市场传言,这次十万卡集群的建成时间也是2027年。时间点的重合耐人寻味。
另一个线索来自业绩说明会。当投资者追问S6000在互联网行业的订单,管理层没有否认,回应是“以公告为准”。行业惯例里,这种“不否认不展开”的态度本身就传递了确定性预期。万卡级的成熟经验打底,新一代产品的性能空间留白,这笔订单的含金量远不止账面数字。
Q3能否提前盈利?
当然,京东这笔订单对于摩尔线程业绩的影响也非常值得关注,关键在于交付的节奏。
按行业惯例,十万卡级集群按季度分批交付确认,Q3起摩尔线程或将进入密集的"订单兑现期"。叠加京东AI研发投入同比增长超200%、S5000在JoyAI训练推理上的规模化复用,以及云端产品占总收入97.5%的高毛利结构,规模效应快速显现。摩尔线程在Q3存在较大概率实现季度盈利,营收有望大幅超出市场预期。
若互联网大厂算力采购需求持续释放,摩尔线程也存在2026年全年实现盈利的可能性,商业化兑现节奏或将快于此前市场预期。
从“故事”到“答卷”
国产GPU赛道正在经历关键切换。过去拼融资能力、产品定义,现在拼收入兑现、集**付。摩尔线程上半年17.36亿的营收排在国产GPU“四小龙”第一位。万卡集群已经跑通,十万卡订单已经落定,供应链备货充足。
国产芯片用十万卡证明了一件事:它不再是Plan B。接下来的问题只有一个——订单能转化成多少收入和利润。这才是真正考验商业化成色的时刻。
免责声明:上述内容仅代表发帖人个人观点,不构成本平台的任何投资建议。
