


探秘StartLux:把Jev请下王座的中国公司,凭什么被看好?
出品 | 创业最前线
作者 | 许一心
编辑 | 闪电
美编 | 邢静
审核 | 颂文
当下模型发布的玩法越来越多:换马甲发,已经司空见惯;卡点对手发布狙击也很流行;甚至还有发了撤回后再发的。但有一条行业铁律:敢在长假期间发布核心成果的公司,一般都有超硬核的实力。道理很简单:长假中权威评测难以快速跟进,无法靠第三方出圈,只能依靠产品本身的硬实力自证。
这个国庆,StartLux选择在假期交出答卷。
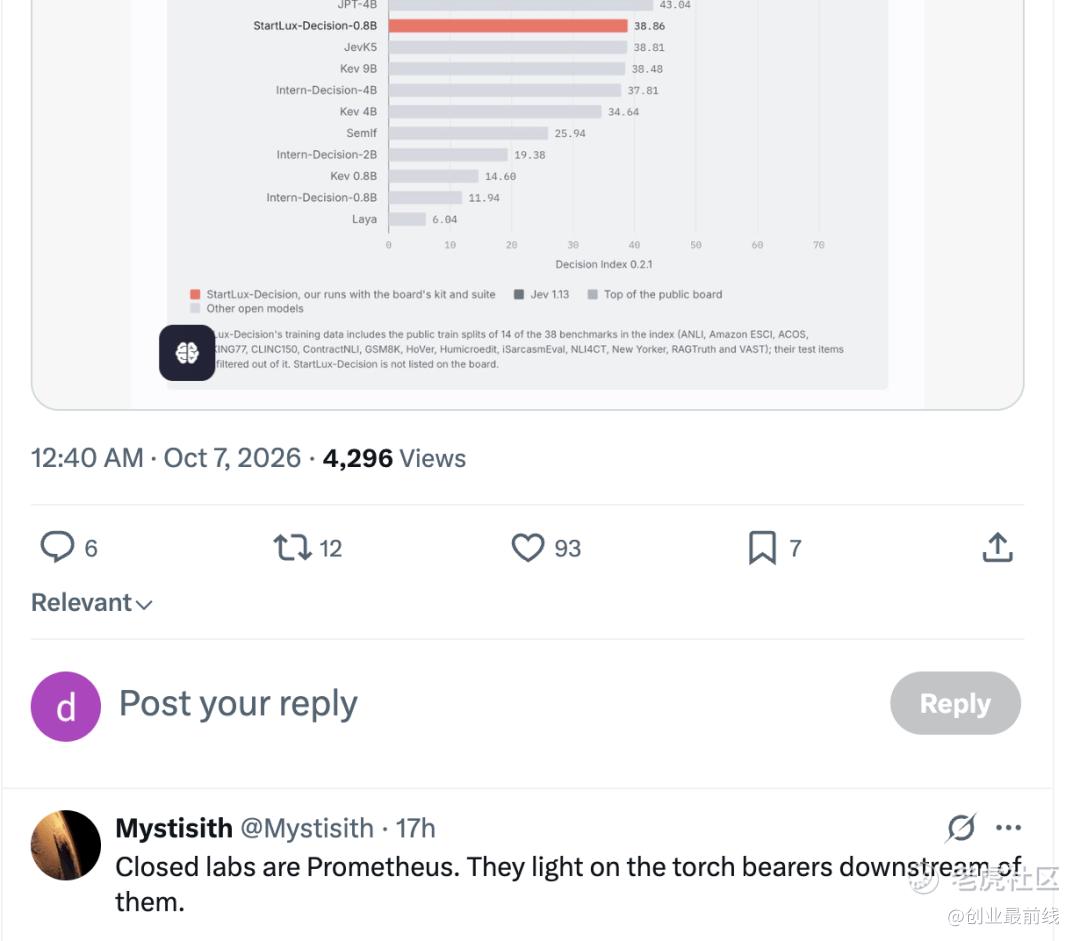
9月30日,成立仅四个多月的StartLux(原点星辉)开源了决策模型StartLux-Decision,从确定方向到完成首轮研发验证只用了3天。在独立评测Decision Index 0.2.1的38项基准中,StartLux-Decision-27B有31项高于Jev 1.13这个在两周前还占据赛道榜首的美国模型。
截至10月8日,模型在Hugging Face上的下载量已突破53000。海外社交平台X上有网友评价StartLux-Decision:这些实验室如同普罗米修斯,为下游的火炬手点亮火种。
(图 / X)
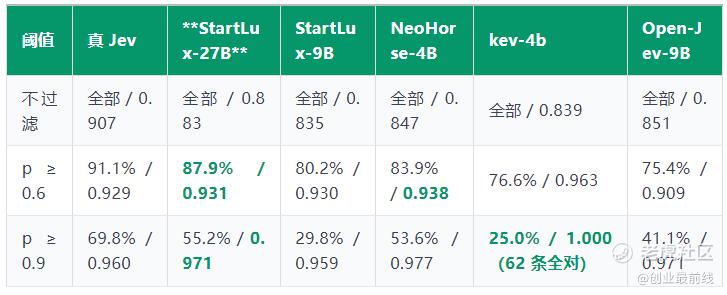
而且,它获得好评,靠的不只是官方自测。国庆假期期间,有技术自媒体自行搭建环境,将StartLux-Decision与Jev及其他9个同类模型放在同一套248题测试集上逐一实测。结论是:在所有本地可部署的开源模型中,只有StartLux-Decision-27B真正接近了云端Jev的水平——总分0.883对0.907,而在开启置信度门控后,27B在门槛内的准确率甚至反超了Jev裸跑的成绩。
(图 / 靠谱项目助手微信公众号)
这是StartLux第二次拿出让行业注意的成绩。上一次是8月底,它的StartLux-27B在中国信通院MCP专项测试中排名第二,以27B的参数量超过了284B的DeepSeek-V4-Flash。
一次赢或许是偶然,两次赢就值得追问方法了,特别是这个模型还和目前最热的RSI有关。
RSI(递归自我改进),是2026年下半年AI行业最热,也最说不清楚的一个词。
说它热,因为几乎9月每一周都有重磅消息。
说它说不清楚,因为从自动跑实验到AI决定下一步研究什么、再到AI改进自身改进能力的递归闭环,每一步跨越的难度都是重量级的,但行业里经常把它们混在一起谈。
而这次发布的价值,除了跑分上的压制以外,StartLux更是拿出了一套完整的工程化流程和对行业都有启发意义的分级标准,这让这件事情从单点胜利走向了行业进化。
100多年前,福特汽车用标准化的流水线大幅提升效率,让汽车走向大众,并开启了现代大规模生产与消费时代。现在,一家AI公司对RSI的实践,让人看到了这种突破性节点逐渐临近,这正是AI激烈竞争中最具价值的地方。
1、它赢了谁,又是怎么赢的?
StartLux-Decision发布几天后,一位拿到测试权限的开发者在GitHub上传了一个叫HELURIO Kids Fit的项目,用4B版本做的儿童语音试衣间。
用户对着镜头说“帮我换成黄色T恤”,本地跑着的模型判断用户要的是哪一件,云端的试衣服务就把黄色T恤“穿”到用户身上。整个判断在一台搭载M5 Pro芯片的MacBook上完成,耗时约100毫秒。项目不大,9个commit。
这位开发者选了4B版本,不是0.8B,也不是更大的9B。她的理由很实在:4B在理解孩子的口语和响应速度之间找到了最好的平衡点。
要理解这件事的意义,得先知道这个模型战胜了谁。
Jev,美国TypeSafe AI公司9月中旬推出的决策模型,发布后迅速走红。StartLux实现对Jev的赶超,意味着在这个世界级赛道刚被点亮的窗口期,就拿到了领先位置。在输入模态上,Jev仅支持文本与JSON输入,StartLux-Decision在此基础上拓展了图像输入能力,可直接依托画面和结构化状态进行决策。
那么决策模型到底是什么?
智能体干活的时候,大量步骤其实只是小判断,下一步点哪个按钮、调用哪个工具、任务是不是已经完成。这类判断如果交给大模型,它要先想一想、写一段话再给你答案。但很多时候你不需要一段话,你需要的只是一个选择。
决策模型就是干这个的:开发者把选项摆好,它直接挑,并报出每个选项有几成把握。就像脊髓反射,手碰到火会缩回来,并不用经过大脑。
在现实里,这就是“一条订单被重复扣费,但仍显示未支付”的客服投诉进来,该交给哪个团队、今天要不要处理、问题有多严重——三个判断,一次请求,同时做完并做对。
它能做的不止客服分流。在星际争霸2里,它为人族选择建造目标和攻防策略,战胜了游戏内置的困难级AI;它与Jev对弈国际象棋,36局赢了35局;在购物任务中,用户要求买“最便宜、免运费的8节装AA电池”,它同时核对了型号、数量、价格和运费,而不是见便宜就拿下,最后完成下单并符合全部条件约束。
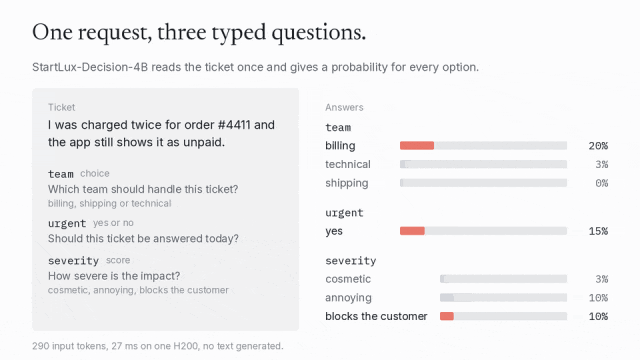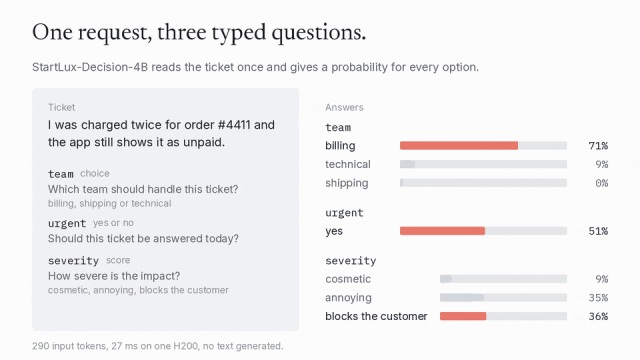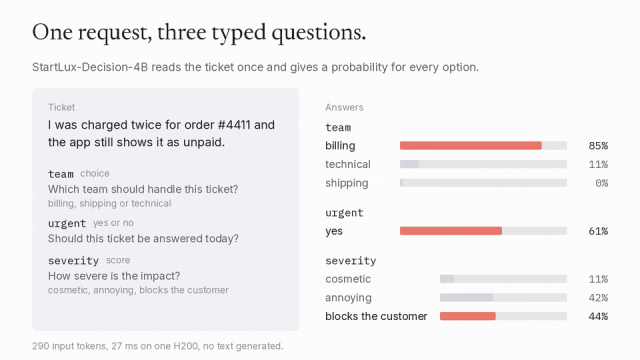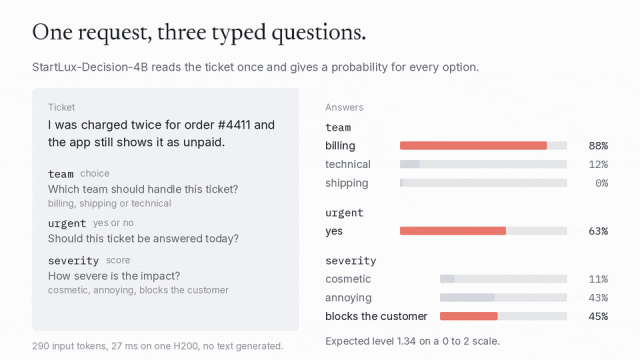
看完场景,再看三个数字。它们其实回答的是同一个问题。
第一个数字是26毫秒。
这是4B版本在一张H200显卡上一次回答三个问题的平均耗时。人眨一下眼大约300毫秒,在这个时间里,它已经能完成十轮判断。
第二个数字是31/38。
在Decision Index的38项基准中,27B版本有31项超过Jev,综合得分63.88对57.91。当然它不是每一项都赢,比如知识与推理是44.3对51.4;但在语言理解、检索分类、工具与自动化这些更贴近决策模型实际用途的能力上,StartLux在绝大多数项目上领先。
第三个数字是4.48GB。
这是它的4B版本压缩后的文件大小,和一部高清电影差不多。如此小的模型,在231道公开题的复测中,压缩版的答案与原版完全一致。这个数字回答的是:它能不能装进普通人的电脑。答案是能。
2、3天迭代,是怎么做出来的?
1913年,福特在海兰帕克工厂启用移动流水线。不到一年,T型车底盘的装配时间从十二个半小时缩短到一个半小时左右。此后T型车一辆接一辆从这条线上开下来,价格一路降到普通家庭买得起。
那一年值得记住的不是某一辆车,而是那条生产线背后的思想范式转变。
StartLux并没有着急地大声地喊出来“我也做到了AI研究AI”,但事实上它们干的就是这件事。因为即使从最低限度上,StartLux也把模型研发做成了一套可持续迭代的工程系统,叫Auto Research。
8月底,这套系统产出的StartLux-27B在信通院测试中排名第二。一个月后,它又产出了StartLux-Decision,一次推出五档版本。发布后没几天,系列又上线了第六个版本35B-A3B,回答耗时只有27B的一半。
一个月,两个模型,六档规格,虽然没有大声喊出来RSI,但这种迭代速度本身就很说明问题。
StartLux联合创始人兼CTO郭权玮透露过一个关键信息:StartLux换一个新的基座模型,整套后训练一周内就能完成,九成以上的数据和经验可以直接复用。
因此,理解“3天”的关键,不单单是它做得快,而是达到这条线之前,它自己已经跑了多少轮。
Auto Research怎么运转,是理解这个问题的关键:在这套系统中,提出假设、构造数据、训练、评测和分析失败,AI都深度参与。研究员把握的是研究目标、评价标准和关键取舍。
为此,郭权玮特意给过两组数字:生成配置、启动训练、运行评测这类体力活,自动化已超过95%。但95%不是重点。真正重要的是另一个数,在“下一步研究什么”这个决策环节,AI的参与比例约为七成。
做体力活的自动化不稀奇,能参与决定研究方向的自动化才是RSI真正的门槛。
郭权玮举过一个金融任务的例子。模型在计算前没有回查原始数据,直接给出错误结果。系统捕捉到这类失败后,几个不同的AI模型分别分析原因、提出改进方案,系统随后自动构造数据、重新训练、重新评测,检查其他能力有没有退化,结果再进入下一轮。
这套系统到底走到了RSI的哪一步?郭权玮为此提出了一套五级标准。
Level0自我纠错,发现错误后能重新试。
Level1记忆/经验,能积累和复用经验。
Level2自动训练,能自主生成数据、启动训练、运行评测。
Level3自动研究,能分析失败,提出假设,决定下一步。
Level4真正的RSI,改进AI的能力本身也在增强,可以形成递归反馈。
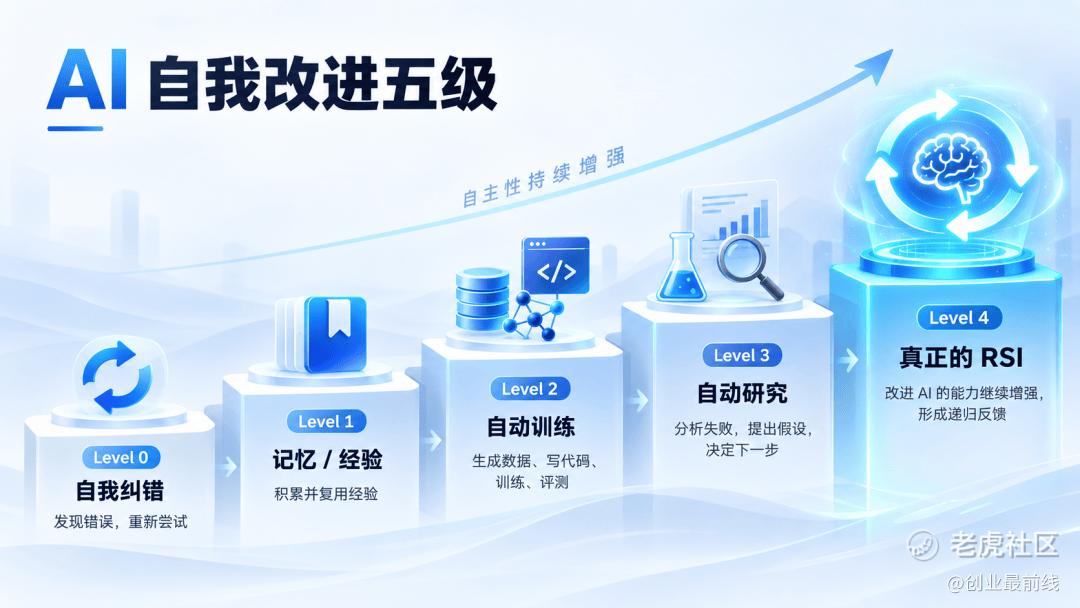
按这套标准,StartLux把自己放在Level3,很谨慎。同时,郭权玮谈到外界所说的“第一”时,有些云淡风轻,因为他只把它看作一个时间点上的记录。
但是,能定出标准的公司,往往是对那个方向想得最深的公司。
2024年,OpenAI用聊天机器人、推理者、智能体、创新者、组织五个阶段描绘通往AGI的道路,此后被整个行业广泛引用,深刻影响了业界对AI发展阶段的讨论方式。StartLux能为AI的自我改进提出类似的阶梯式分级,说明它在这个问题上的思考深度,已经远远超出了“做一个好模型”的层面。
3、为什么是本地?
Decision模型只是StartLux技术能力的一个切面。要理解这家公司真正的行业生态位,要看它选了一条什么样的路,以及这条路为什么走得通。
StartLux最核心的选择,是把“本地智能”当作一整套系统来做,而不只是做一个能装进电脑的模型,然后称之为本地模型或本地智能。
这两件事听起来像一回事,其实完全不同。
做一个本地模型,是把一个大模型压小、塞进消费级设备。做一套本地智能系统,是从一开始就按本地的约束来设计整个架构,模型只是其中一层,而且是可以替换的一层。不同任务、不同设备,可以选择不同的通用模型和专项模型。决策模型管高频判断,往上是智能体和记忆系统,往下是推理引擎、量化和硬件适配。
这个架构图不是事后总结的。9月,整个行业密集确认了决策模型是智能体系统中缺失的一层——Jev走红、OpenAI推出Decisions API、Cloudflare开源Clef,都发生在这个月。
但之所以StartLux格外值得关注,是因为它的这一格,是先画好的。Decision模型和Personal Agent,都在它既有的规划中。
这才是此次发布有分量的核心原因:它不是追着热点做了一个决策模型,而是按蓝图补上了一块。下一次行业确认某个新的能力层,它的蓝图上可能也已经有了对应的位置。
为什么本地路线更容易把RSI做成?有两条结构性的理由。
第一条是试错成本。RSI的核心动作是一轮又一轮地试验,单次实验越便宜,同样的预算就能试更多次,走错了也换得起路线。Karpathy的autoresearch把一次实验压到约5分钟,一张GPU一晚就能完成近百次尝试。StartLux的本地模型规模相对紧凑,同样的计算资源可以支撑更密集的迭代。
第二条是数据在身边。本地模型运行在用户自己的电脑里,日常使用的过程本身就在产生改进模型的信号。郭权玮做过一个判断:云端是所有人共用同一个模型,本地则可以让每个人的AI拥有一条独立的进化轨迹。
当然,本地RSI也有一个绕不过的问题:千万台电脑上的模型如果都在自我更新,如何保证可控?郭权玮的原则很清楚——把探索的自由和修改自己的权限分开。模型可以在隔离环境中大胆尝试,但任何更新要替换正在使用的版本,都必须经过独立验证和回归测试,并保留随时回滚的能力。
1965年,曾与图灵共事的英国数学家I.J.Good写道,第一台超智能机器,将是人类需要做出的最后一项发明。此后半个多世纪,人们对这句话的想象几乎都指向同一个画面,一台集中在某处的超级机器,不断自我升级。
StartLux想走的是另一条路。StartLux创始人陈大年说,AGI不靠一个至高无上的神,要靠80亿人各自的模型,每一个都各有所长、千变万化、性格迥异。如果这条路走通,自我改进将不再是模型公司实验室里的事,而是发生在每个人自己的电脑上。到那一天,AI第一次真正属于它的主人。
4、结语
回到标题的问题。当模型更替以周计算,权重的保质期越来越短,什么才是更值得关注的长期价值?
一条能持续出好模型的生产线具备长期价值。StartLux一个月内从同一套系统中交出两个模型、六档规格,换基座一周跑完,数据九成以上复用。它不依赖某一次突破性实验,而是把出成果变成了可重复的过程。
一套想清楚了的架构具备长期价值。本地智能的蓝图不是事后对着热点画的,决策模型和Personal Agent都在既有规划中。当行业确认了某个新的能力层,发现StartLux的图纸上已经有了这一格,这种战略预判力比任何单次的榜单成绩都更稀缺。
一套给自己设了硬约束的RSI标准具备长期价值。五级分得清清楚楚,StartLux没有往上吹,自评离RSI的最高形态还差一级。敢在RSI最热的时候说自己还没做到真正的RSI,这本身就是一种判断力。
(图 / 摄图网,基于VRF协议)
据悉,StartLux首款面向公众的本地智能系统在研发,有望在短期内和大家见面。前两次模型发布验证了研发体系,接下来要接受检验的是整体的产品体验。届时,“本地”赛道将迎来重磅玩家,面向普通人的AI也将由StartLux给出一个新的可能性。
*注:文中题图来自摄图网,基于VRF协议。
免责声明:上述内容仅代表发帖人个人观点,不构成本平台的任何投资建议。
