


英伟达把光引擎搬上芯片,国产 1.6T 同周量产
AI集群现在连电信号多走几厘米都嫌费电了。
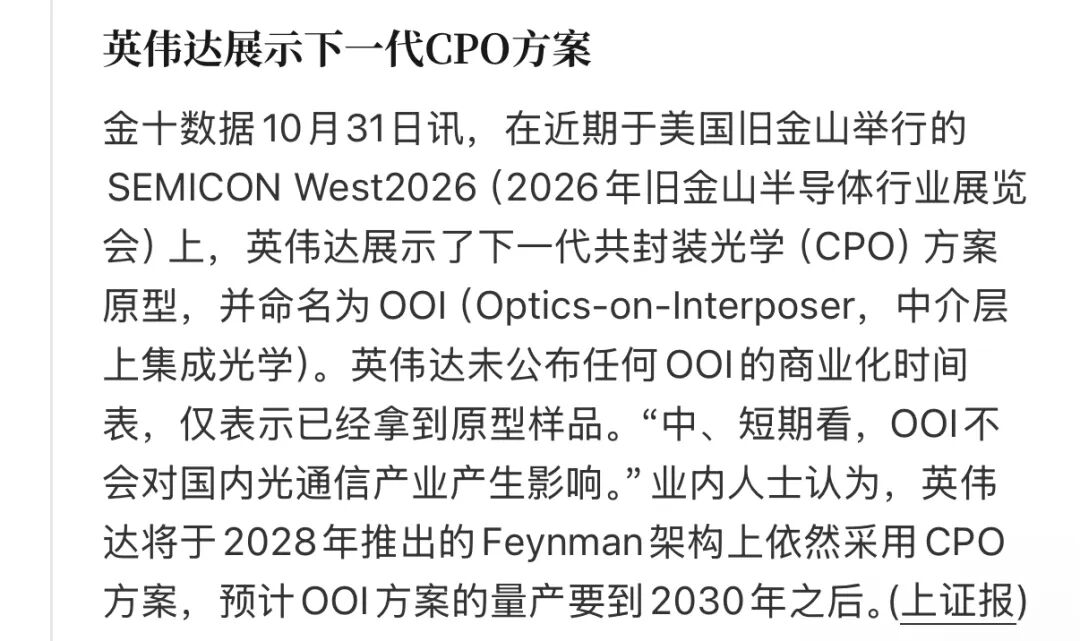
英伟达在旧金山展示了下一代OOI原型,直接把光引擎搬上硅中介层,把中间的有机基板都省了。。
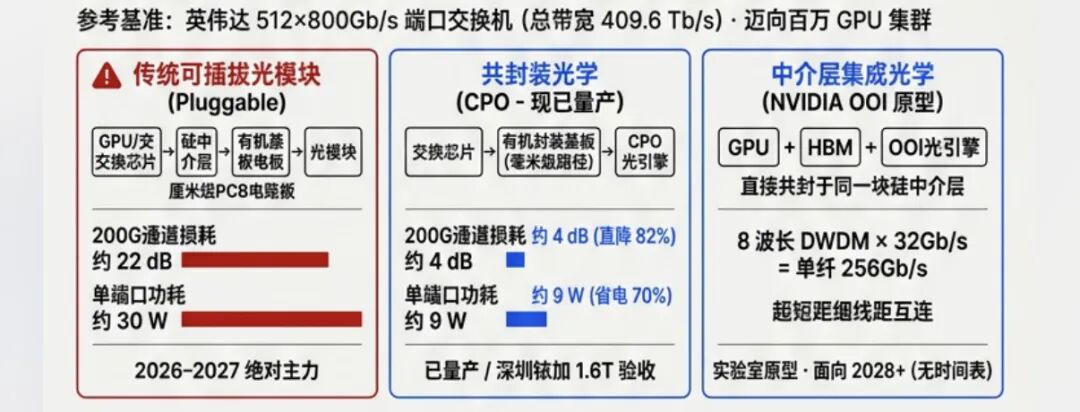
这相当于把光引擎当成HBM内存来封装,跟GPU或者交换芯片贴在同一块硅中介层上,电信号走更短、线距更细的互连。
为什么要这么折腾?因为数据搬运太吃电了。传统交换机在200G通道下,电信号走几厘米电路板,损耗约22dB,单端口功耗约30W。
换成现在已经量产的CPO共封装光学,路径缩到毫米级,损耗降到约4dB,单端口功耗直接砍到约9W,省了70%的电。像英伟达512个800Gb/s端口的交换机,总带宽算下来是409.6Tb/s,以后建百万GPU工厂,不砍掉通信功耗根本跑不动。
国内这边也没闲着。
深圳铱加科技的1.6T/3.2T CPO光引擎研发项目传出通过审核验收,下一步准备部署1.6T量产。但问题是,这事目前还没看到官方公告交叉证实,1.6T量产时间、良率和客户订单全没披露,产线能不能大规模出货我现在不知道。
而且英伟达那个OOI也还在研究阶段,连正式送样都没确认,面向的是2028年以后的需求,根本没有商业化时间表。。。这能提振光么?
免责声明:上述内容仅代表发帖人个人观点,不构成本平台的任何投资建议。
点赞
举报
登录后可参与评论

暂无评论