


GPU板块跌宕起伏,市场在博弈什么?
最近两天,A 股 GPU 板块走出冰火两重天。11 月 18 日,英伟达方面宣布 H200 将不再向中国出货,国产算力板块集体拉升,摩尔线程领涨7.28%,寒武纪、沐曦股份跟涨4.89%、2.65%;11 月 19 日,市场又传出三星晶圆代工已停止为中国算力芯片企业提供流片服务的小作文,导致国产GPU板块大幅回落,截至收盘,燧原科技跌停、沐曦股份跌超14%、摩尔线程跌8.34%。
GPU板块的大起大落之间,投资者们在焦虑和担心什么?当海外算力越来越难获得,谁真能接住国内大模型的训练需求?谁才是真正的自主可控?
要回答上面问题,得先看清国产GPU此刻站在什么位置上。
一、芯片墙越砌越高,GPU“自主化”迫在眉睫
市场情绪的波动不是空穴来风,背后是市场对国产GPU产业自主化信心的变化。
GPU是AI产业竞争的底座,也是国运之战的关键。
Anthropic CEO 达里奥・阿莫迪近期的发言把话说得很直白:美国必须在AI上领先中国,中国什么都强,唯独芯片落后。对美方而言,保障AI与大模型领先的核心手段,就是在GPU产业上建筑高墙。
这座墙正在从多个方向同时加高。
第一层是芯片本身。英伟达B300的价格和溢价一路上行,即便手握重金,依然一卡难求。
第二层是硬件溯源。“硬件指纹” 风波把 “模型用什么设备训练” 摆到了台面上,过去藏在训练底层的硬件轨迹,可能面临更严格的溯源与审查。
第三层是远程算力。海外 Cloud 和 API 算力租赁开始收紧。实体芯片进不来,远程算力也可能用不了,国内团队借道海外获取算力的后路,正在被逐一堵上。
此外,美方11月16日进一步收紧先进 AI 芯片出口管制,近期市场还传出三星晶圆代工已停止为中国算力芯片企业提供流片服务。虽然这一消息后来被证实为假消息,但海外代工受限的趋势已经形成。
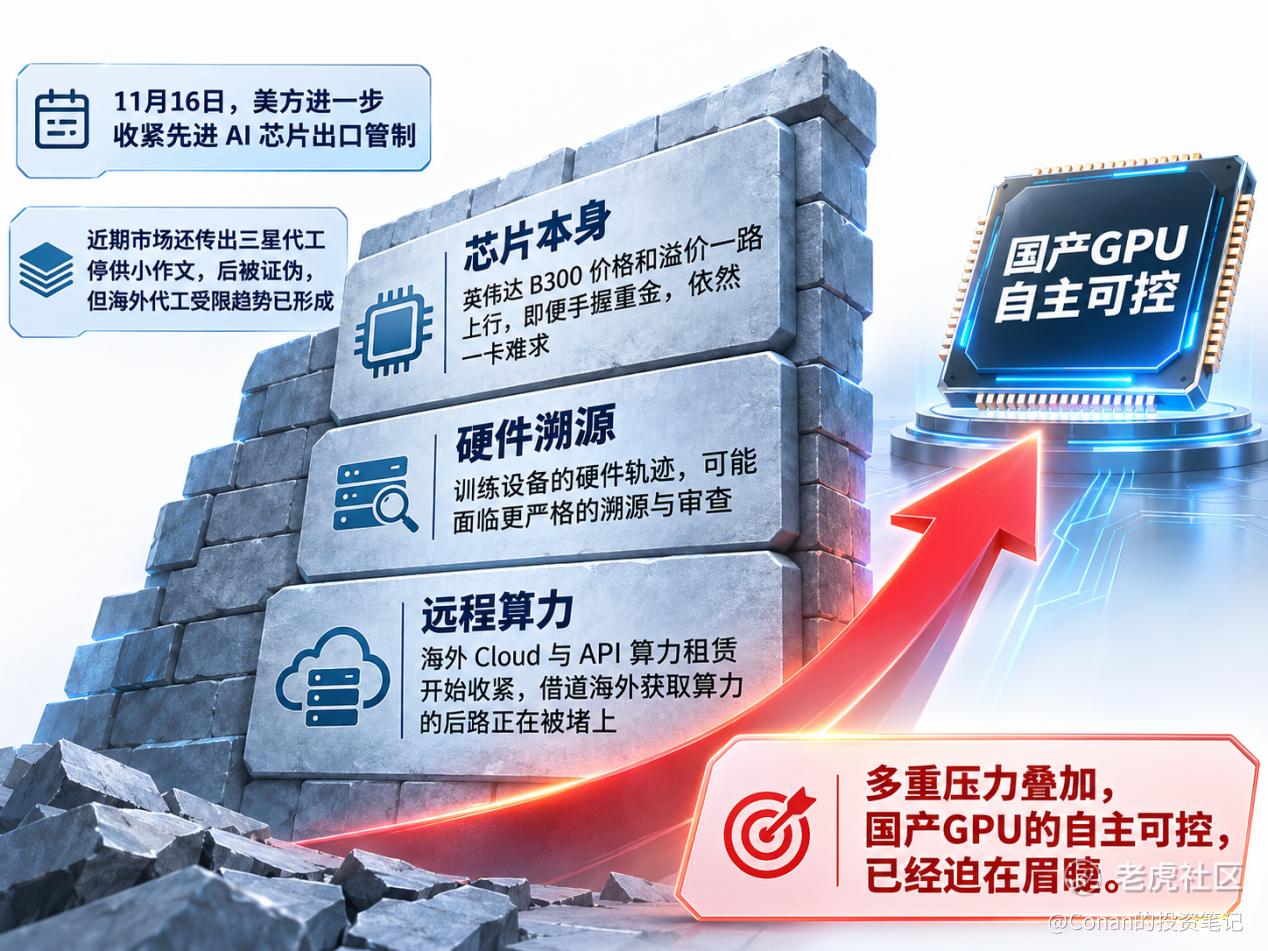
多重压力叠加,结论只有一个:国产GPU的自主可控,已经迫在眉睫。
二、国产GPU差在什么地方?
站在行外视角看,实现国产替代似乎不难:既然海外卡用不了,那就换成国产卡。
可了解AI大模型的人都知道,这条路太难了。
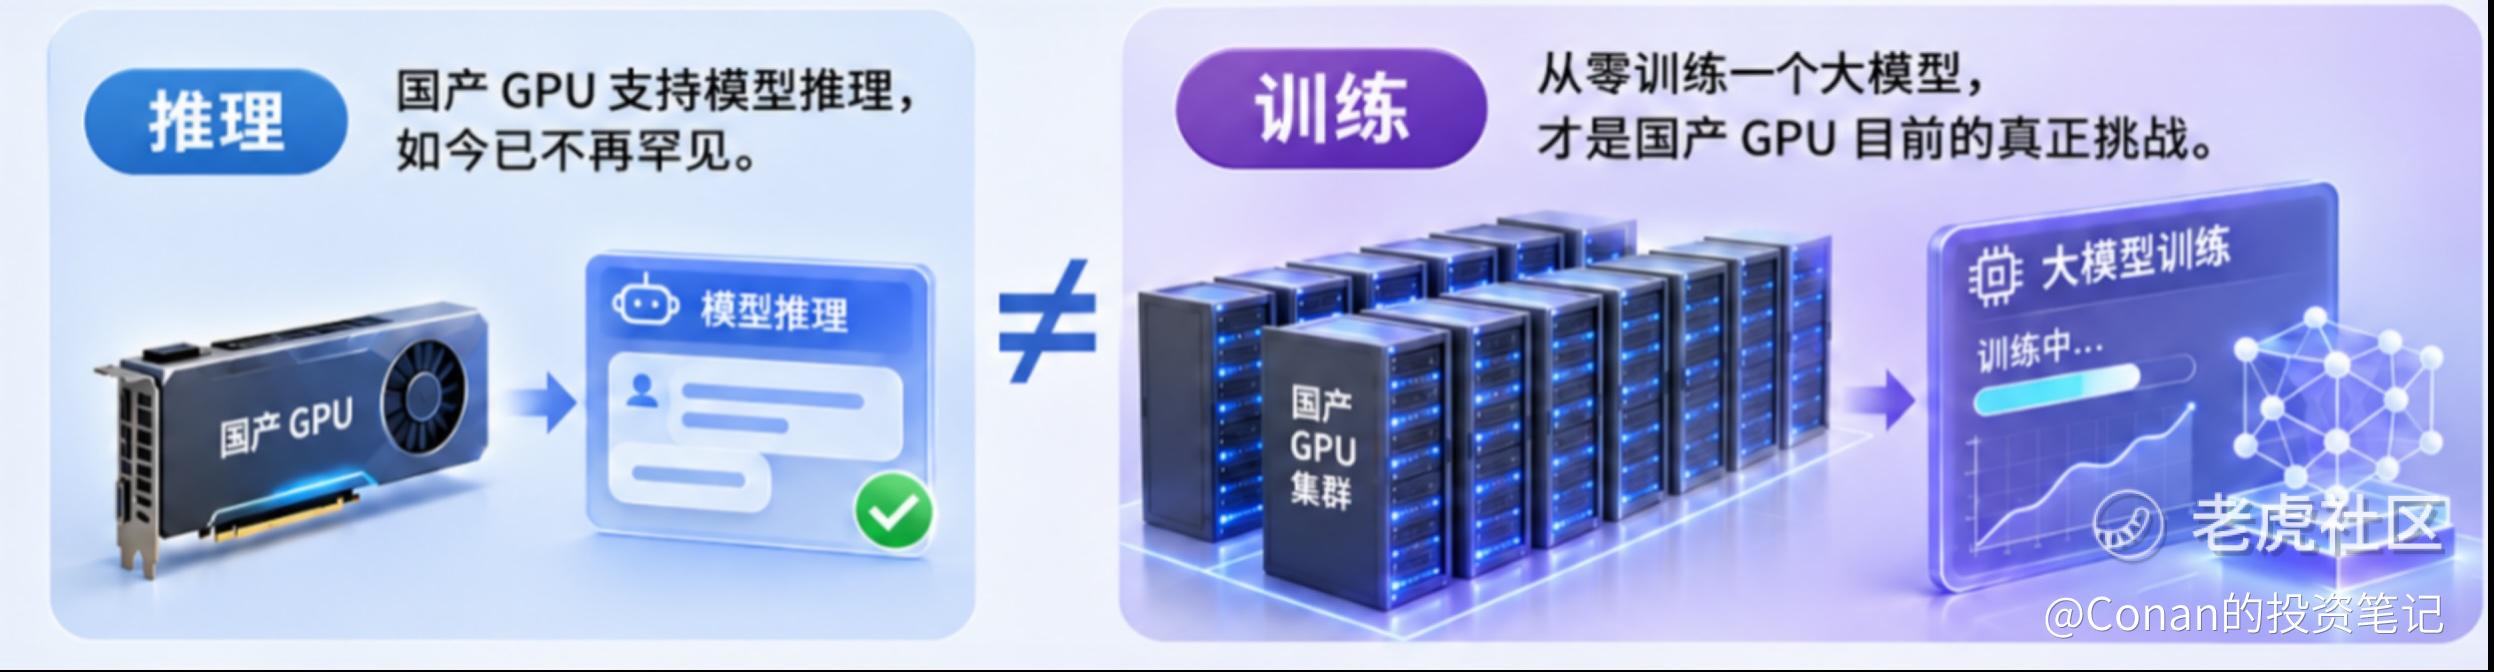
国产GPU支持模型推理,这几年已经不算新鲜事。可从 “能推理” 走到 “能从零训出一个大模型”,难度是跳级的。
先是规模关。成百上千张卡要连续运行数周甚至数月,集群通信、硬件稳定性、任务调度,任何一环频繁出问题,都会拖慢整个进度;更麻烦的是,训练一旦中断,此前投入的算力和时间往往要重来。
再是生态关。英伟达的CUDA不只是一套工具,它背后是十几年积累下来的算子库、框架适配和开发习惯。客户从英伟达迁到国产芯片,框架要换、算子要重写、调度要重新调优,试错的代价不只是钱,而是几个月的时间窗口。
两关叠加起来,行业真正缺的从来不是又一张参数表,而是能在国产集群上把大模型完整训出来的成功案例。
就在行业被这道关卡住的时候,之江实验室的 “021” 给出了一个答案。
021是之江实验室推出的科学基础模型,名字取自Zero to One,也就是“从0到1”。简单来说,021既解决了多模态科学数据难以统一建模的问题,也验证了国产算力能够从头训练超大规模模型。
021目前有320亿、2360亿和万亿参数三个版本。其中,320亿参数模型完成了科学数据原生训练,2360亿参数模型融合数学与代码能力,并在国产集群上走完了全流程训练;体量更大的万亿参数版本,目前也在国产算力集群上稳定训练。
对国产算力而言,这是一次从芯片、集群到软件系统的完整验证 —— 不是某个环节能跑,而是整条链路跑通了。
这张成绩单来得很及时。它让 “国芯训国模” 从技术设想,变成了已经发生过的事实。
那么问题自然跟上来:跑通这套系统的国产GPU,是谁?
三、3年时间,摩尔线程率先落地“训练”计划
答案指向国产GPU龙头摩尔线程。
这要从它与之江实验室的合作说起。三年时间,双方围绕科学模型、国产 GPU、软件栈与集群训练反复磨合,把这套 “国芯训国模” 的闭环真正跑通了。
这三年投入的重心,不在单纯提供算力。摩尔线程在 021 上交付的是三层能力 —— 而这三层,恰好对应客户心里的三个问题:算不算得动、迁不迁得过去、敢不敢押上去。
第一层是训练算力与精度对齐——算不算得动。2360 亿参数的版本在这套系统上完成了全流程训练,万亿参数的版本也做到了稳定训练。重点在于 “能跑”;更关键的是它打破了一个流传很久的印象:国产芯片更适合做推理,训练阶段难以承担。
第二层是软件栈与训练框架的适配——迁不迁得过去。GPU、软件栈跟主流训练框架能协同跑起来,这件事听起来偏技术,落到实际就是省时间和省人力。科研机构和大模型厂商往国产算力上迁移时,不必再做大面积的改造,迁移的门槛和成本被实实在在压下来了。
第三层是集群协同与长时间稳定运行——敢不敢押上去。“021” 从数据处理到模型训练这一整套端到端流程,是靠这套系统支撑起来的。大模型训练最怕的是跑到一半出问题,能长时间稳定运行,才算真本事。也正因为这一层,“国芯训国模” 从一句口号,变成了一次走完全程的实际验证。
这三层里真正值钱的,并不是算力本身。国产芯片能跑推理,行业已经见过不少案例;难建立的是客户对训练系统的信任。模型一旦开始预训练,数据、工程团队和几个月的时间成本就一起押了进去。客户要确认的其实只有三件事:这套系统能不能长时间跑住、出了故障能不能恢复、原来的训练框架能不能顺利迁移。
摩尔线程与之江实验室合作的三年,恰好把这些最费时间的环节逐个磨了一遍。于是完成万亿参数端到端就不再只是一个技术成绩,而成了国产全功能 GPU 足以进入超大模型训练这一高门槛场景的证据。
也正是这一点,构成摩尔线程稀缺的行业卡位:训练。
训练处在大模型产业链的前端。模型在哪套平台上完成预训练,后面的微调、部署和集群扩容,通常也会沿着原来的工具和软件环境继续走。越早进入训练,越有机会留在客户后续的算力投入里。
四、摩尔线程的不一样——绝对的自主可控
“自主可控”这四个字,过去常被投资者当成一句立场表态。但在当下的环境里,它已经从加分项变成了国产GPU企业的生存条件。
自2023年被列入实体清单起,摩尔线程就启动了供应链国产化。这个动作在当时看是防御性的,放到今天看则是提前的对冲。
市场的压力主要来自美国11月16日公布的新规,美国商务部工业与安全局(BIS)进一步收紧先进AI芯片出口管制,重点涉及两个方面。一是加强对海外晶圆代工和封测环节的监管。二是堵住通过第三国获取AI芯片和算力的渠道。
摩尔线程的位置因此显得不同:它不是 “管制来了,临时去找国内替代”,而是制造环节的切换,在管制落地之前就已经完成。据业内信息,摩尔线程下一代主力产品S6000的代工已全部转向国内先进制程。
这也解释了这两天盘面为什么会出现那么大分化。当海外代工通道整体收窄,已经把新增产能放在国内的厂商,和仍高度依赖海外晶圆厂的厂商,风险敞口不在一个量级上。
说到底,自主可控就是两句话:芯片在哪造,产能落在哪。
可以看到的是,供给端的收紧,也在改变需求端的流向。受最新限制影响,国内头部大厂也在加大对国产GPU的采购力度;腾讯高管近期也表示,从长期看,相关限制可能推动更多中国企业转向国内供应链与国产芯片。
再回头看,这两天市场的剧烈摆动,本质是同一个求证:海外算力越来越难获得以后,谁能真正接住国内大模型的训练需求?
021 案例给出的答案,让这件事往前走了一步——2360亿参数模型已完成全流程训练,万亿参数模型也在稳定运行,国产算力开始进入难度更高、价值更大的训练环节。
对摩尔线程来说,这也是它更具想象力的地方:推理带来直接的商业需求,训练则决定模型最初在哪套算力体系里生长。一旦进入这个环节,后面的微调、推理、扩容和生态适配,才有机会顺着同一套平台继续走下去。前端能训,后端能产Token,中间制造落在国内——这条链从头到尾都在自己手里,才叫自主可控。
后英伟达时代的阵痛是真实的,但中国AI产业在极限压力下迸发出的自强与韧性,会更加震撼。
免责声明:上述内容仅代表发帖人个人观点,不构成本平台的任何投资建议。
