


为啥车企要自研大算力自动驾驶芯片?
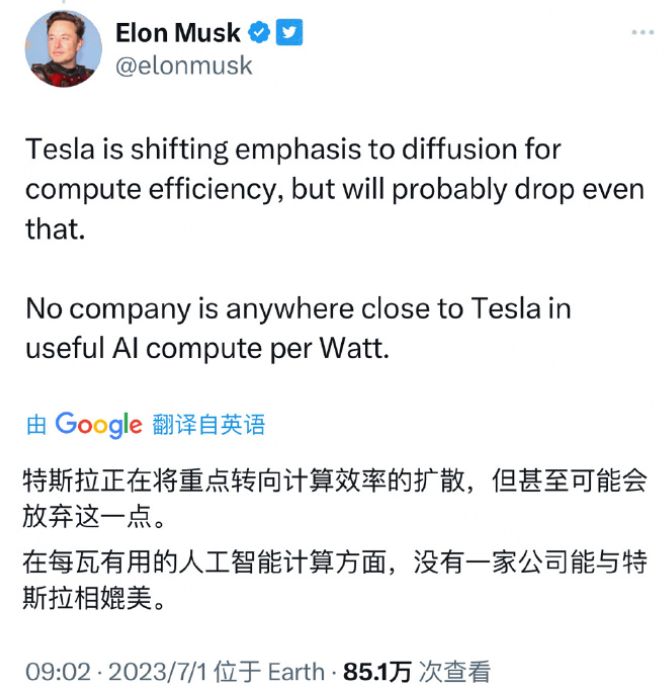
为啥车企要自研大算力自动驾驶芯片,马斯克最近有几个推特可以关注一下。
先说背景:
自研芯片和供应安全有关,但不是核心,原因是在芯片卡脖子阶段,你可以自研但卡你的方式有 N 多种,设计、生产等。
$特斯拉(TSLA)$ 自研,是因为基于自身对人工智能软件(算法)发展趋势,以及自身技术路线的判断。
人话就是,我是根据需要可以设计 CPU、GPU、NPU … 等等 PU 的权重。
这里面很核心的是算法指导硬件开发,硬件承托算法能力,这叫软硬一体。
$英伟达(NVDA)$ 的优势是通用型、稳定性、性能高,但英伟达不一定适用所有算法方案,或者说不一定适用自己的算法方案。
特斯拉自研的主要逻辑,这个很好理解。
所以通用型芯片要跟上软件迭代是一件非常难的事。
自动驾驶工程界的算法演进,受特斯拉影响巨大,从 CNN → BEV → Transformer → 占用网络,这是一个线性进步的过程。
目前国内还在学习 BEV 阶段,这是一个清晰的路径,只是国内的量产节奏都不相同而已。
但最近马斯克也提到正在考虑放弃 Transformer,谷歌翻译是放弃,我的理解应该是在 Transformer 的基础之上做一些计算效能更加高效的模型。
谷歌最早提出 Transformer ,特斯拉发扬光大,Transformer 的优势很大,通过大模型的注意力机制算法可以让图像感知能力倍增,但缺点是对数据量要求极大,注意是极大。
并且 Transformer 对于车端算力要求也高,即使特斯拉自研 HW3.0 对此有针对性优化,但其实目前的 144 T 也有些吃力,这是辅助驾驶进城后数据量和场景激增的现象,也是所有车企包括特斯拉都没有完全预料到的。
所以靠增加算力并不能解决这个问题,因为这又会陷入唯算力适从的境况。
可行的做法是,通过算法和硬件双优化,这也很好理解,但这里面的难度是,对于可行、高效的算法并没有方案可参考,这就是工程界和学术界的代差。
简单说,论文很多,但量产落地是马拉松。
但我们都知道,特斯拉是意外,特斯拉提出了新的解决方案,用 Diffusion 网络模型的概念去做。
Diffusion 本质上是一个生成式模型,用来建模图像并生成图像。
这个网络模型特斯拉也在探索,目前有用信息不太多,但你可以理解成,神经网络通过数据积累自我生成问题,也生成答案。
这是「真端到端」的开端,而是是不是有点熟悉的味道,这也是大火的 GPT 大模型的精髓,去理解 GPT 大模型的成语接龙原理,对 Diffusion 的理解会更简单。
这是真正意义上把 GPT 应用在自动驾驶上的开端。
所以 $蔚来(NIO)$ 做芯片是合理的选择,蔚来做了很多大家好像看不见,很有趣。
简单理解,欢迎指正。
来源:微博-德卤爱开车
免责声明:上述内容仅代表发帖人个人观点,不构成本平台的任何投资建议。
不自研芯片不就是给芯片厂打工么
特斯拉干的不也是华为干的么
蔚来做个芯片,软件都做不利索
从商业角度来看是好处多多
特斯拉现在披露信息太少